

小白不用一开始就研究模型参数,先学会“入口在哪里、适合做什么、怎么提问、怎么迭代”就够了。
需要先分清三个概念:
模型是背后的能力,比如 GPT Image 2.0、Seedream(即梦生图)、Veo;
产品入口是你实际打开使用的地方,比如 ChatGPT、Gemini、豆包、即梦;
聚合平台是把多个模型、素材、画布、工作流放到一起的平台,比如 Lovart、TapNow、FlowPix、LibTV。
一、语言大模型:先学会“问问题”和“让 AI 帮你干活”
各家大语言模型各有各的特点与优势,主要的功能差不多(不过国外的模型都明显强于豆包)。
1. ChatGPT
网页端入口:
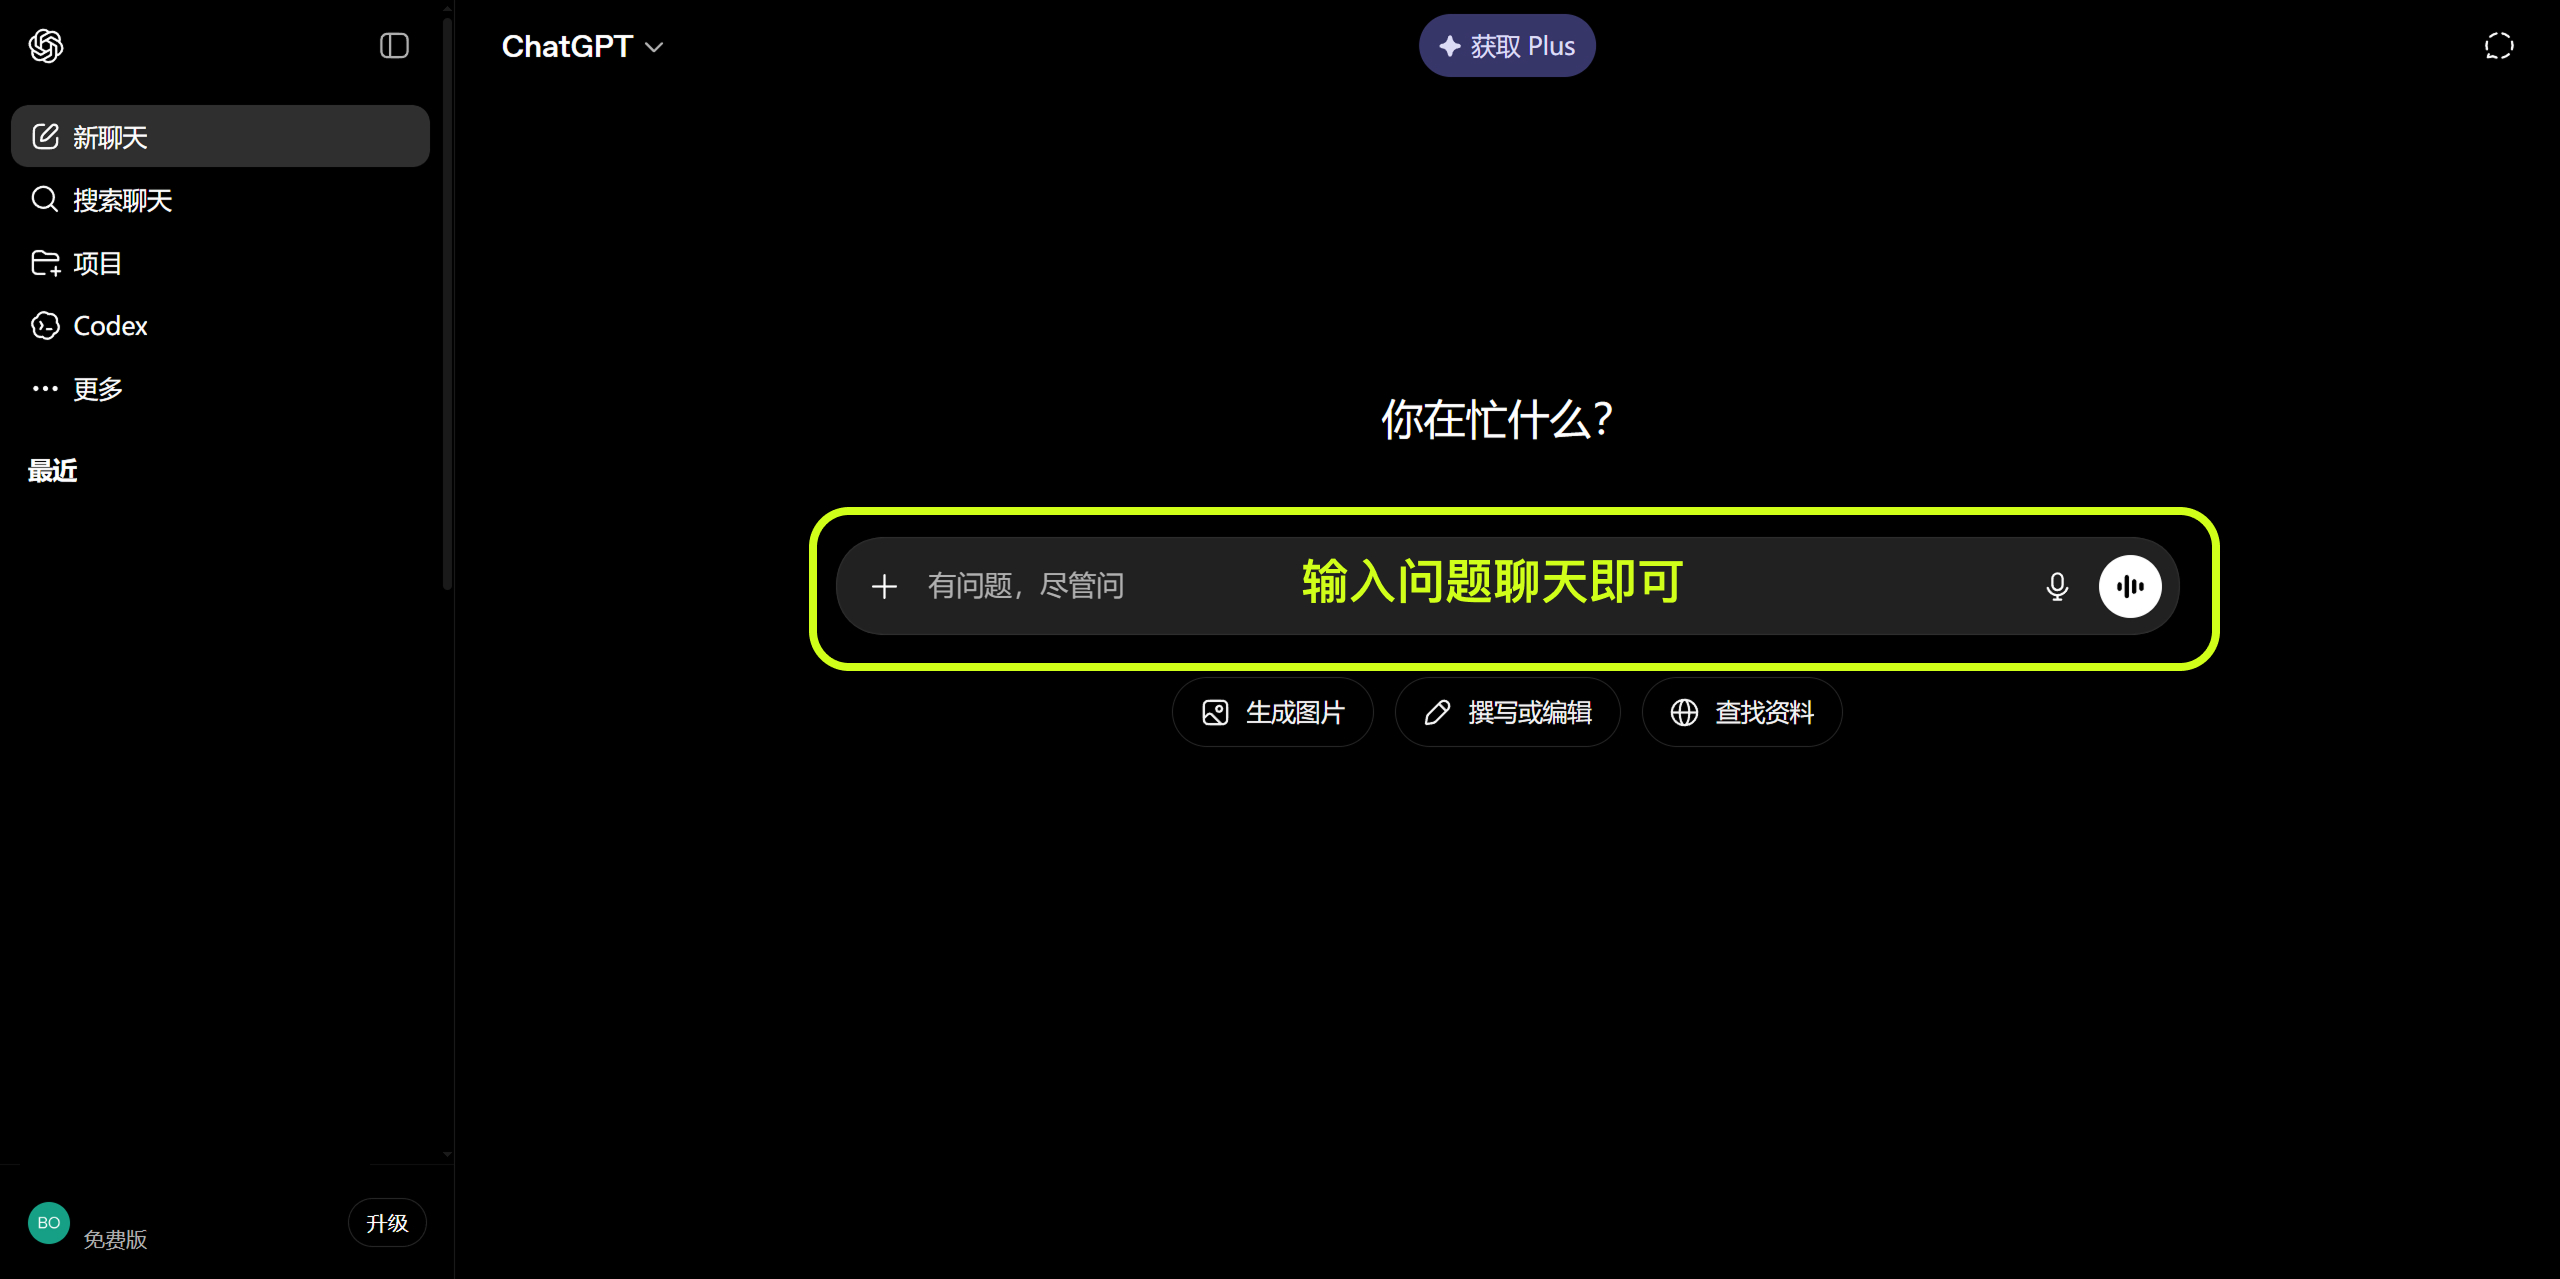
ChatGPT界面
适合做什么:
写文案、改文章、总结资料、翻译、做表格、头脑风暴、学习辅导、代码解释、方案策划,同时可做生成式 AI 创作(生成图片提示词、视频脚本、分镜、内容选题、商业创意方案)
基础用法:
不要只说“帮我写一篇文章”,而是说清楚身份、目标、受众、格式和风格。
2. Gemini
入口:
Gemini 官网
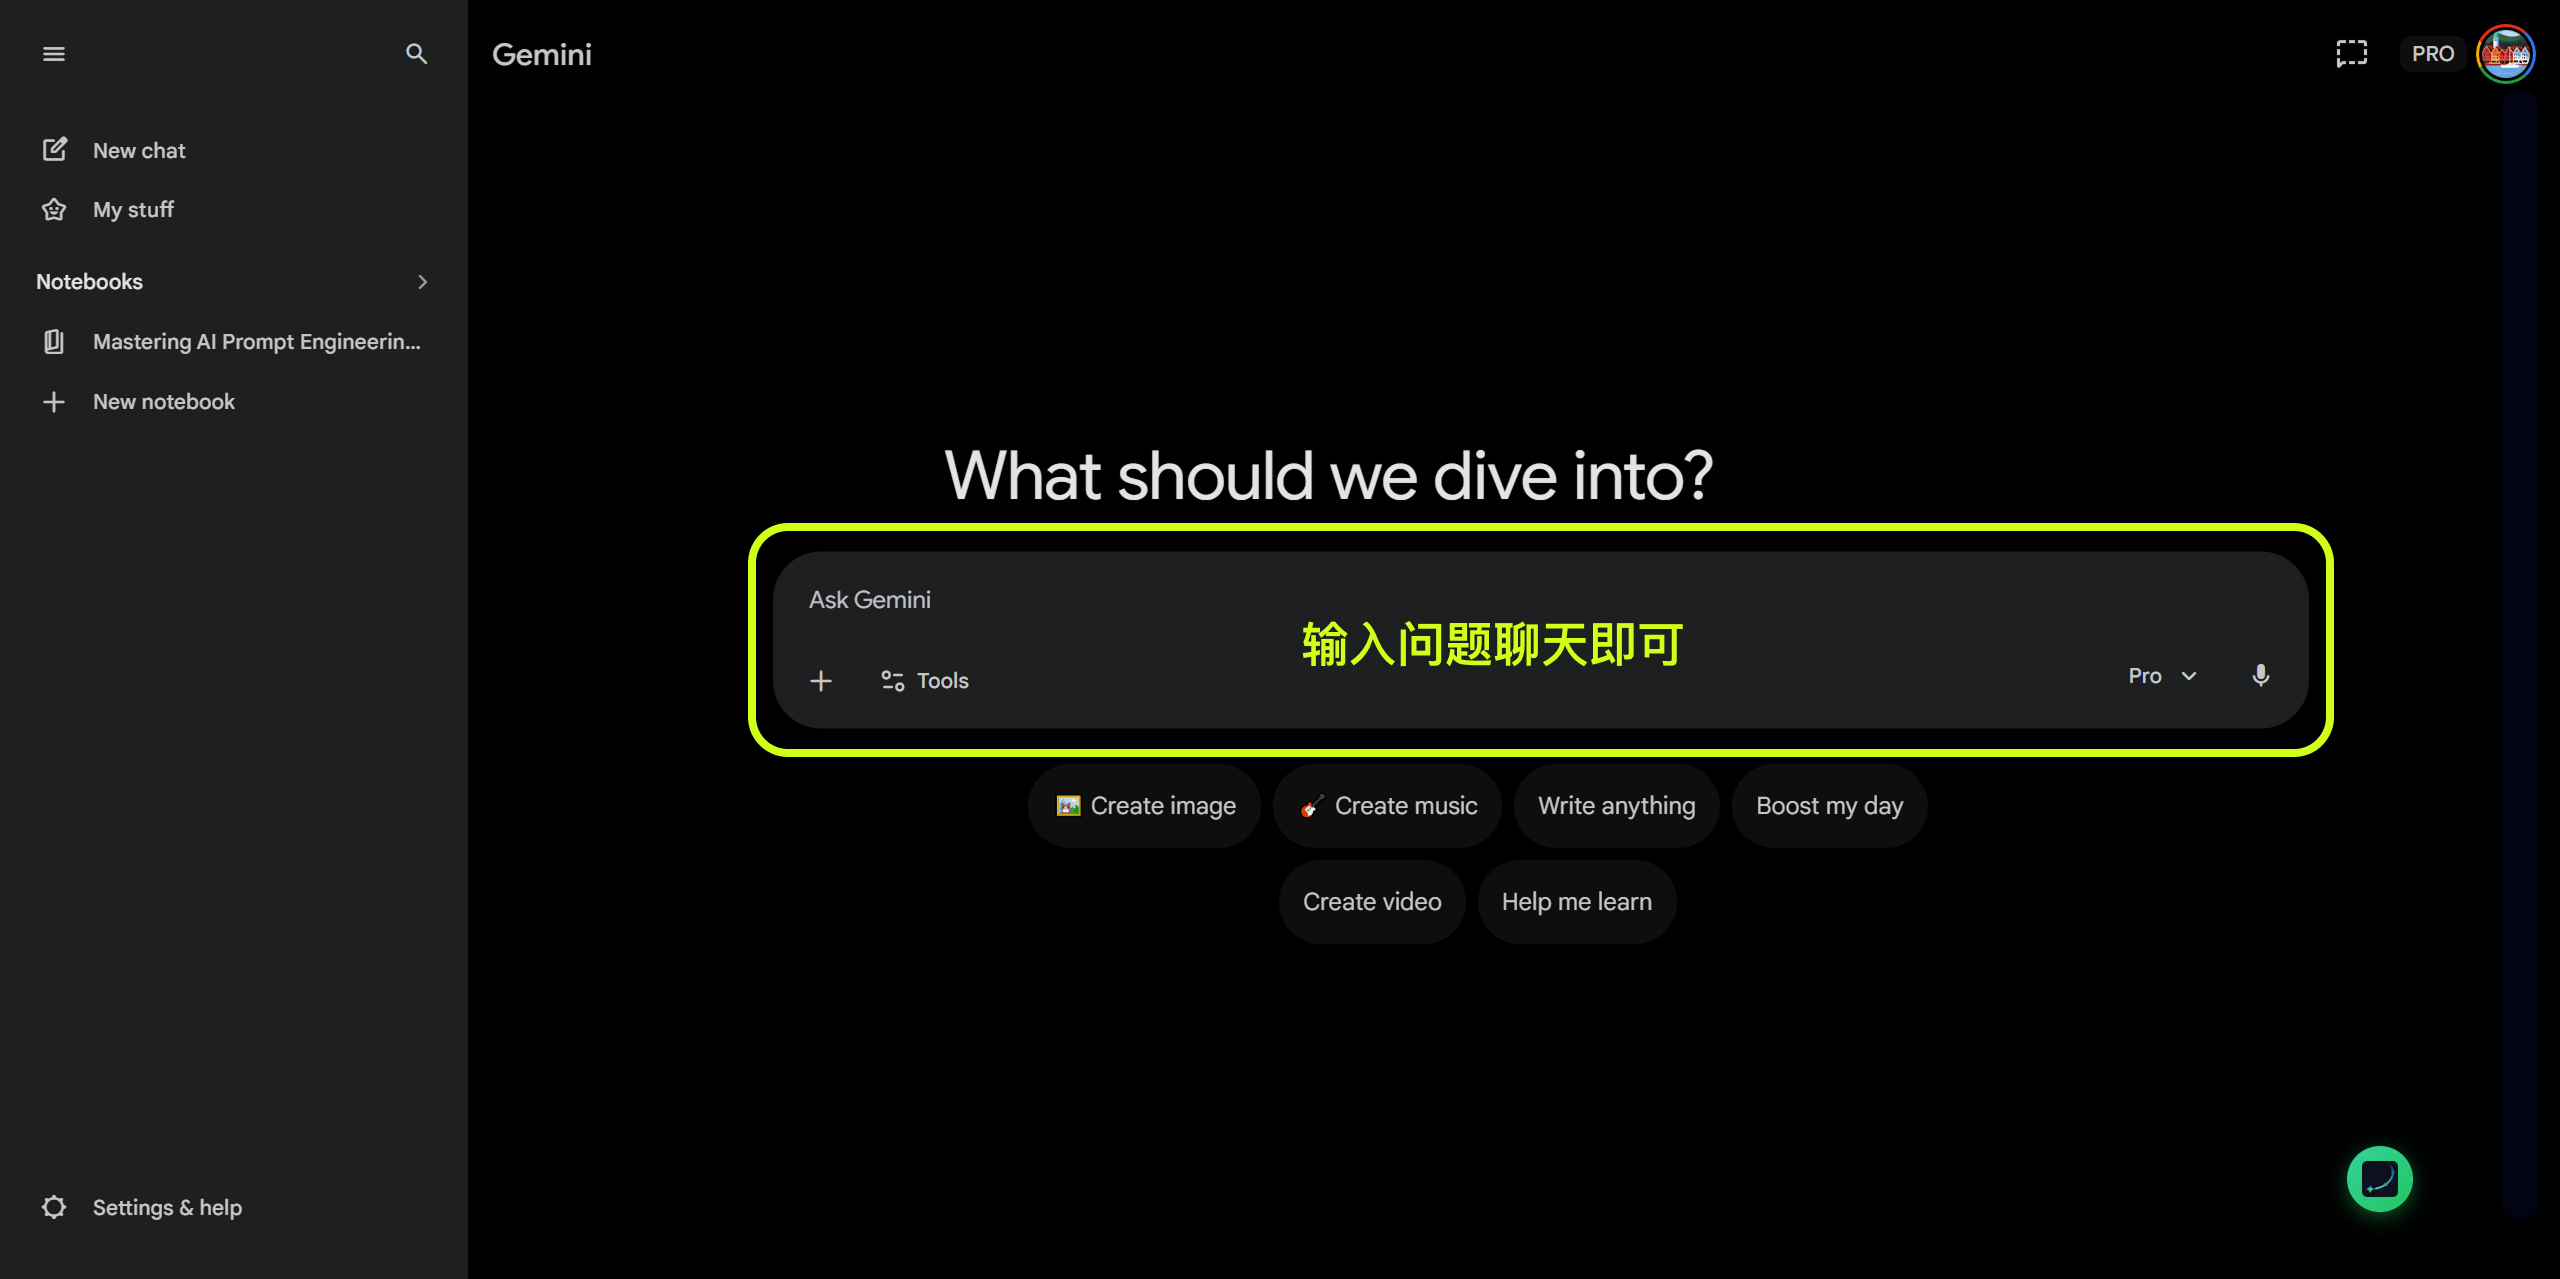
Gemini界面
适合做什么:
搜索式问答、资料整理、英文内容处理、图片理解、图像和视频生成入口,同时可做生成式 AI 创作,例如提示词生成、视频脚本和分镜设计。
Gemini的会员有个好处,一个会员就可以享受绝大部分谷歌的其他AI平台
例如:
2.1
Flow(https://labs.google/fx/tools/flow/)
Google 的 AI 视频与图片创作平台,开通pro会员后可以接近无限的使用Nano banana模型,以及1个月10条veo3.1视频。
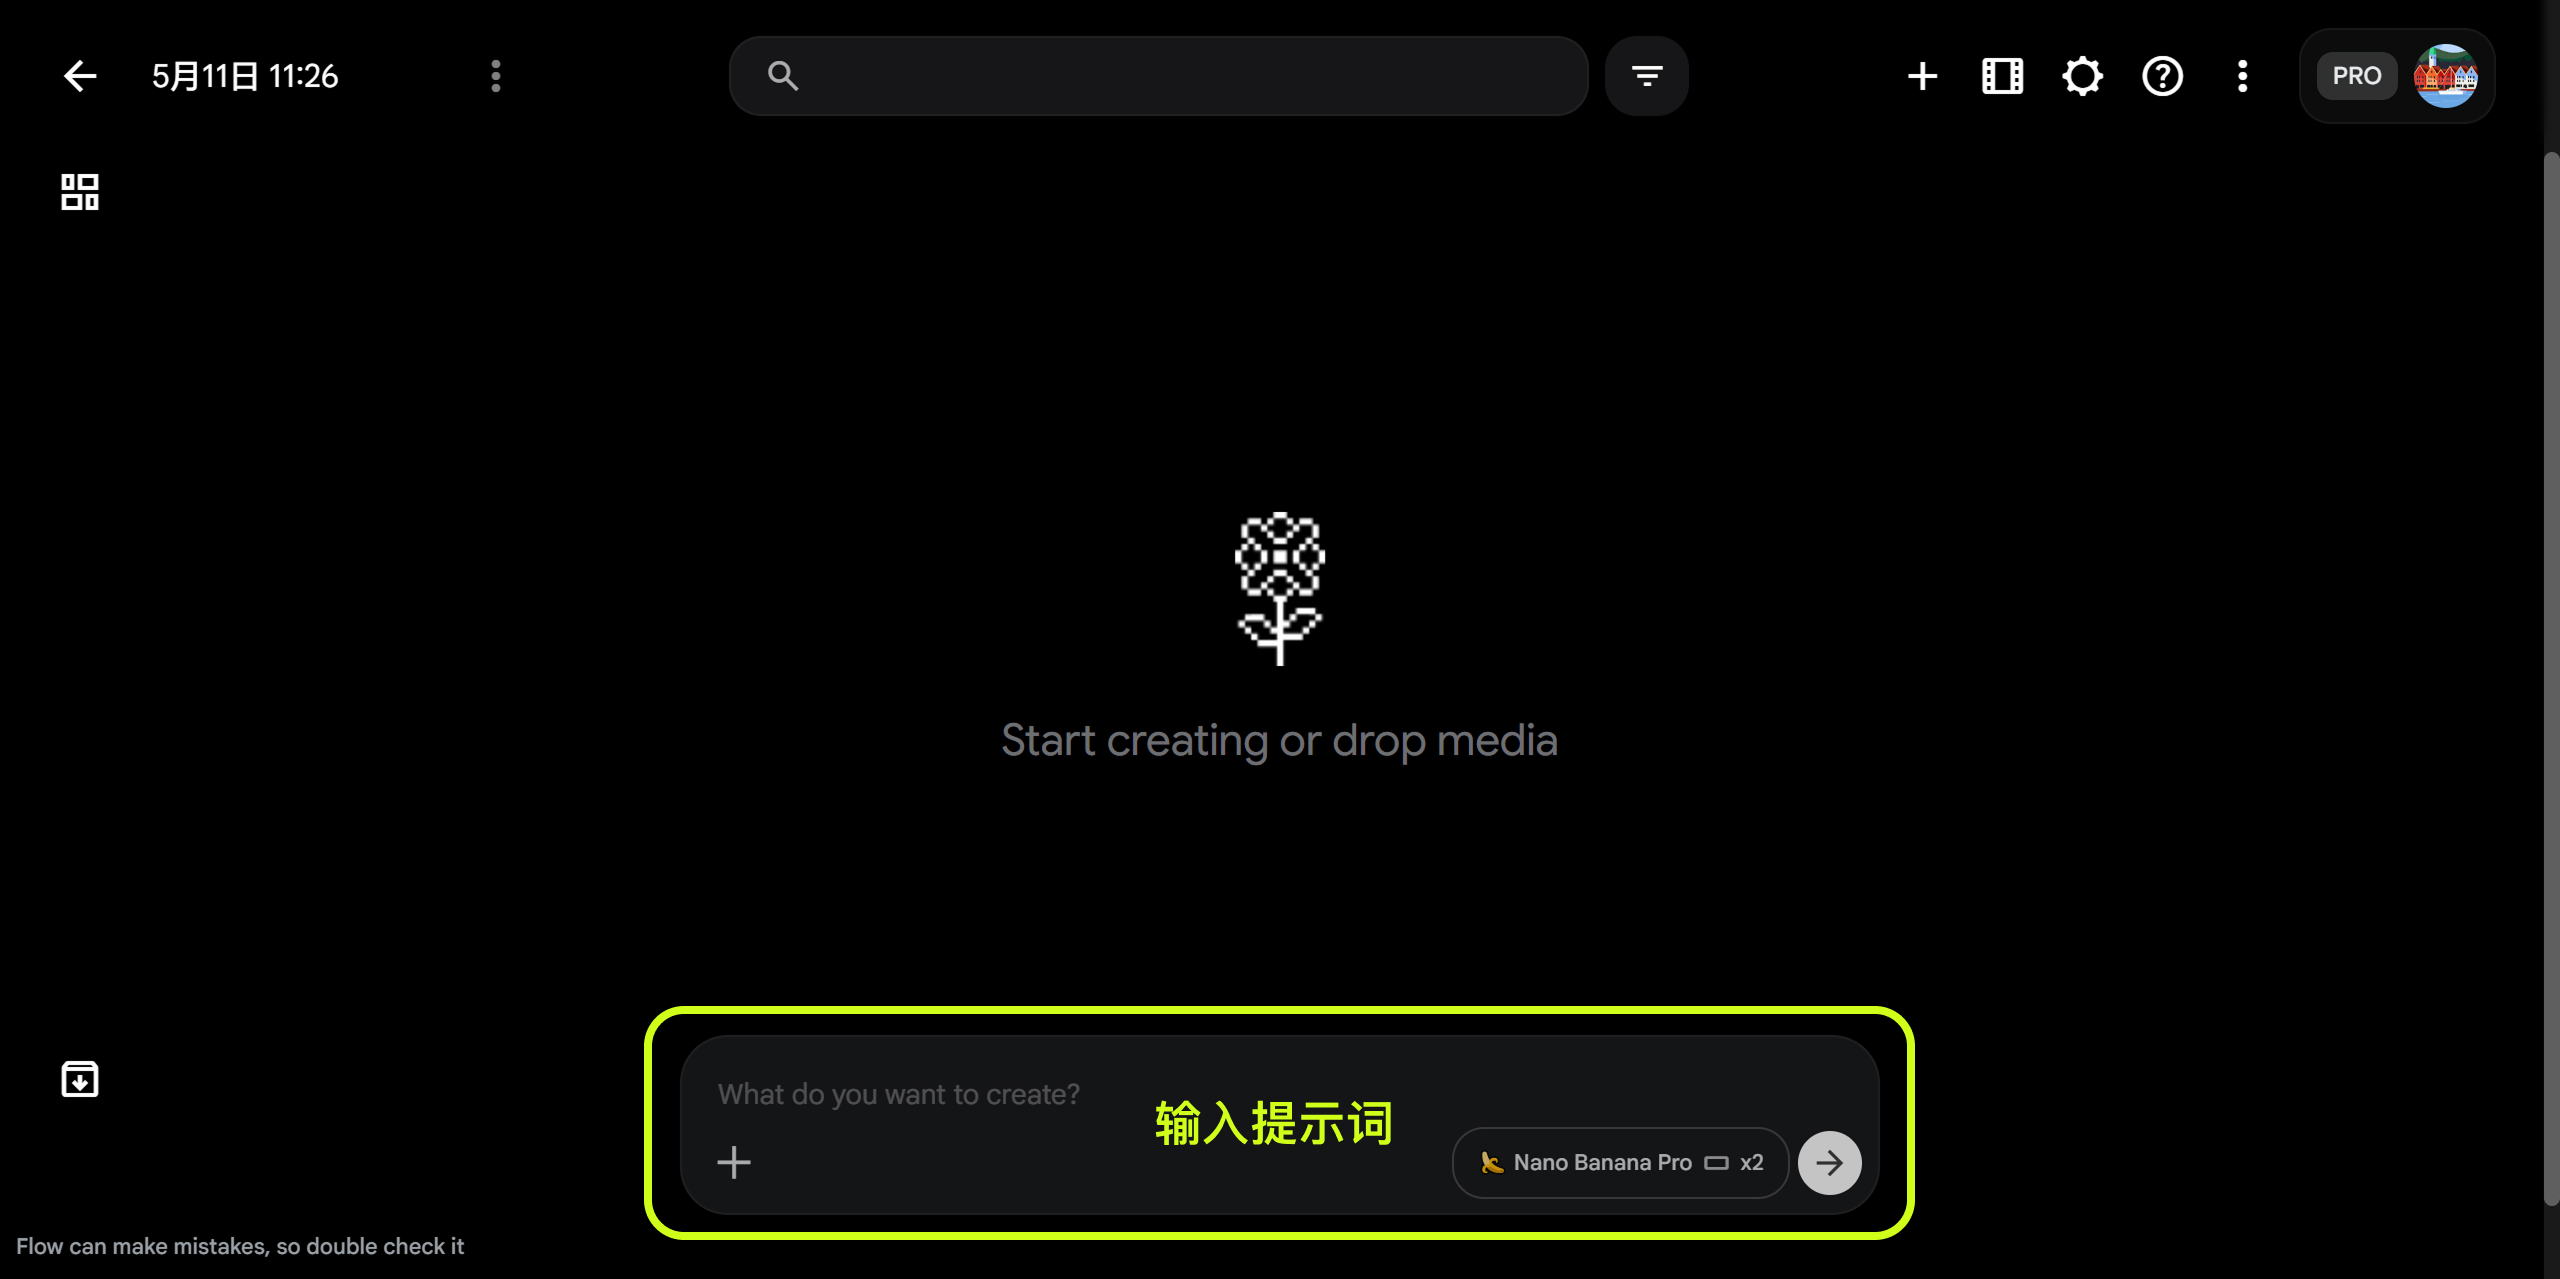
Flow界面
2.2
NotebookLM(https://notebooklm.google/)
NotebookLM 是 Google 的 AI 笔记和资料研究工具,适合上传文档、生成总结、问答、学习笔记、音频概览和视频概览。
2.3
这是偏开发者的平台,可以用来测试 Gemini 模型、做原型、调用 Gemini API、体验 Nano Banana Pro 和 Gemini Pro 模型。
3. 豆包
入口:
国民级免费工具(和CHTGPT 、gemini 相比会差一些,不过免费)
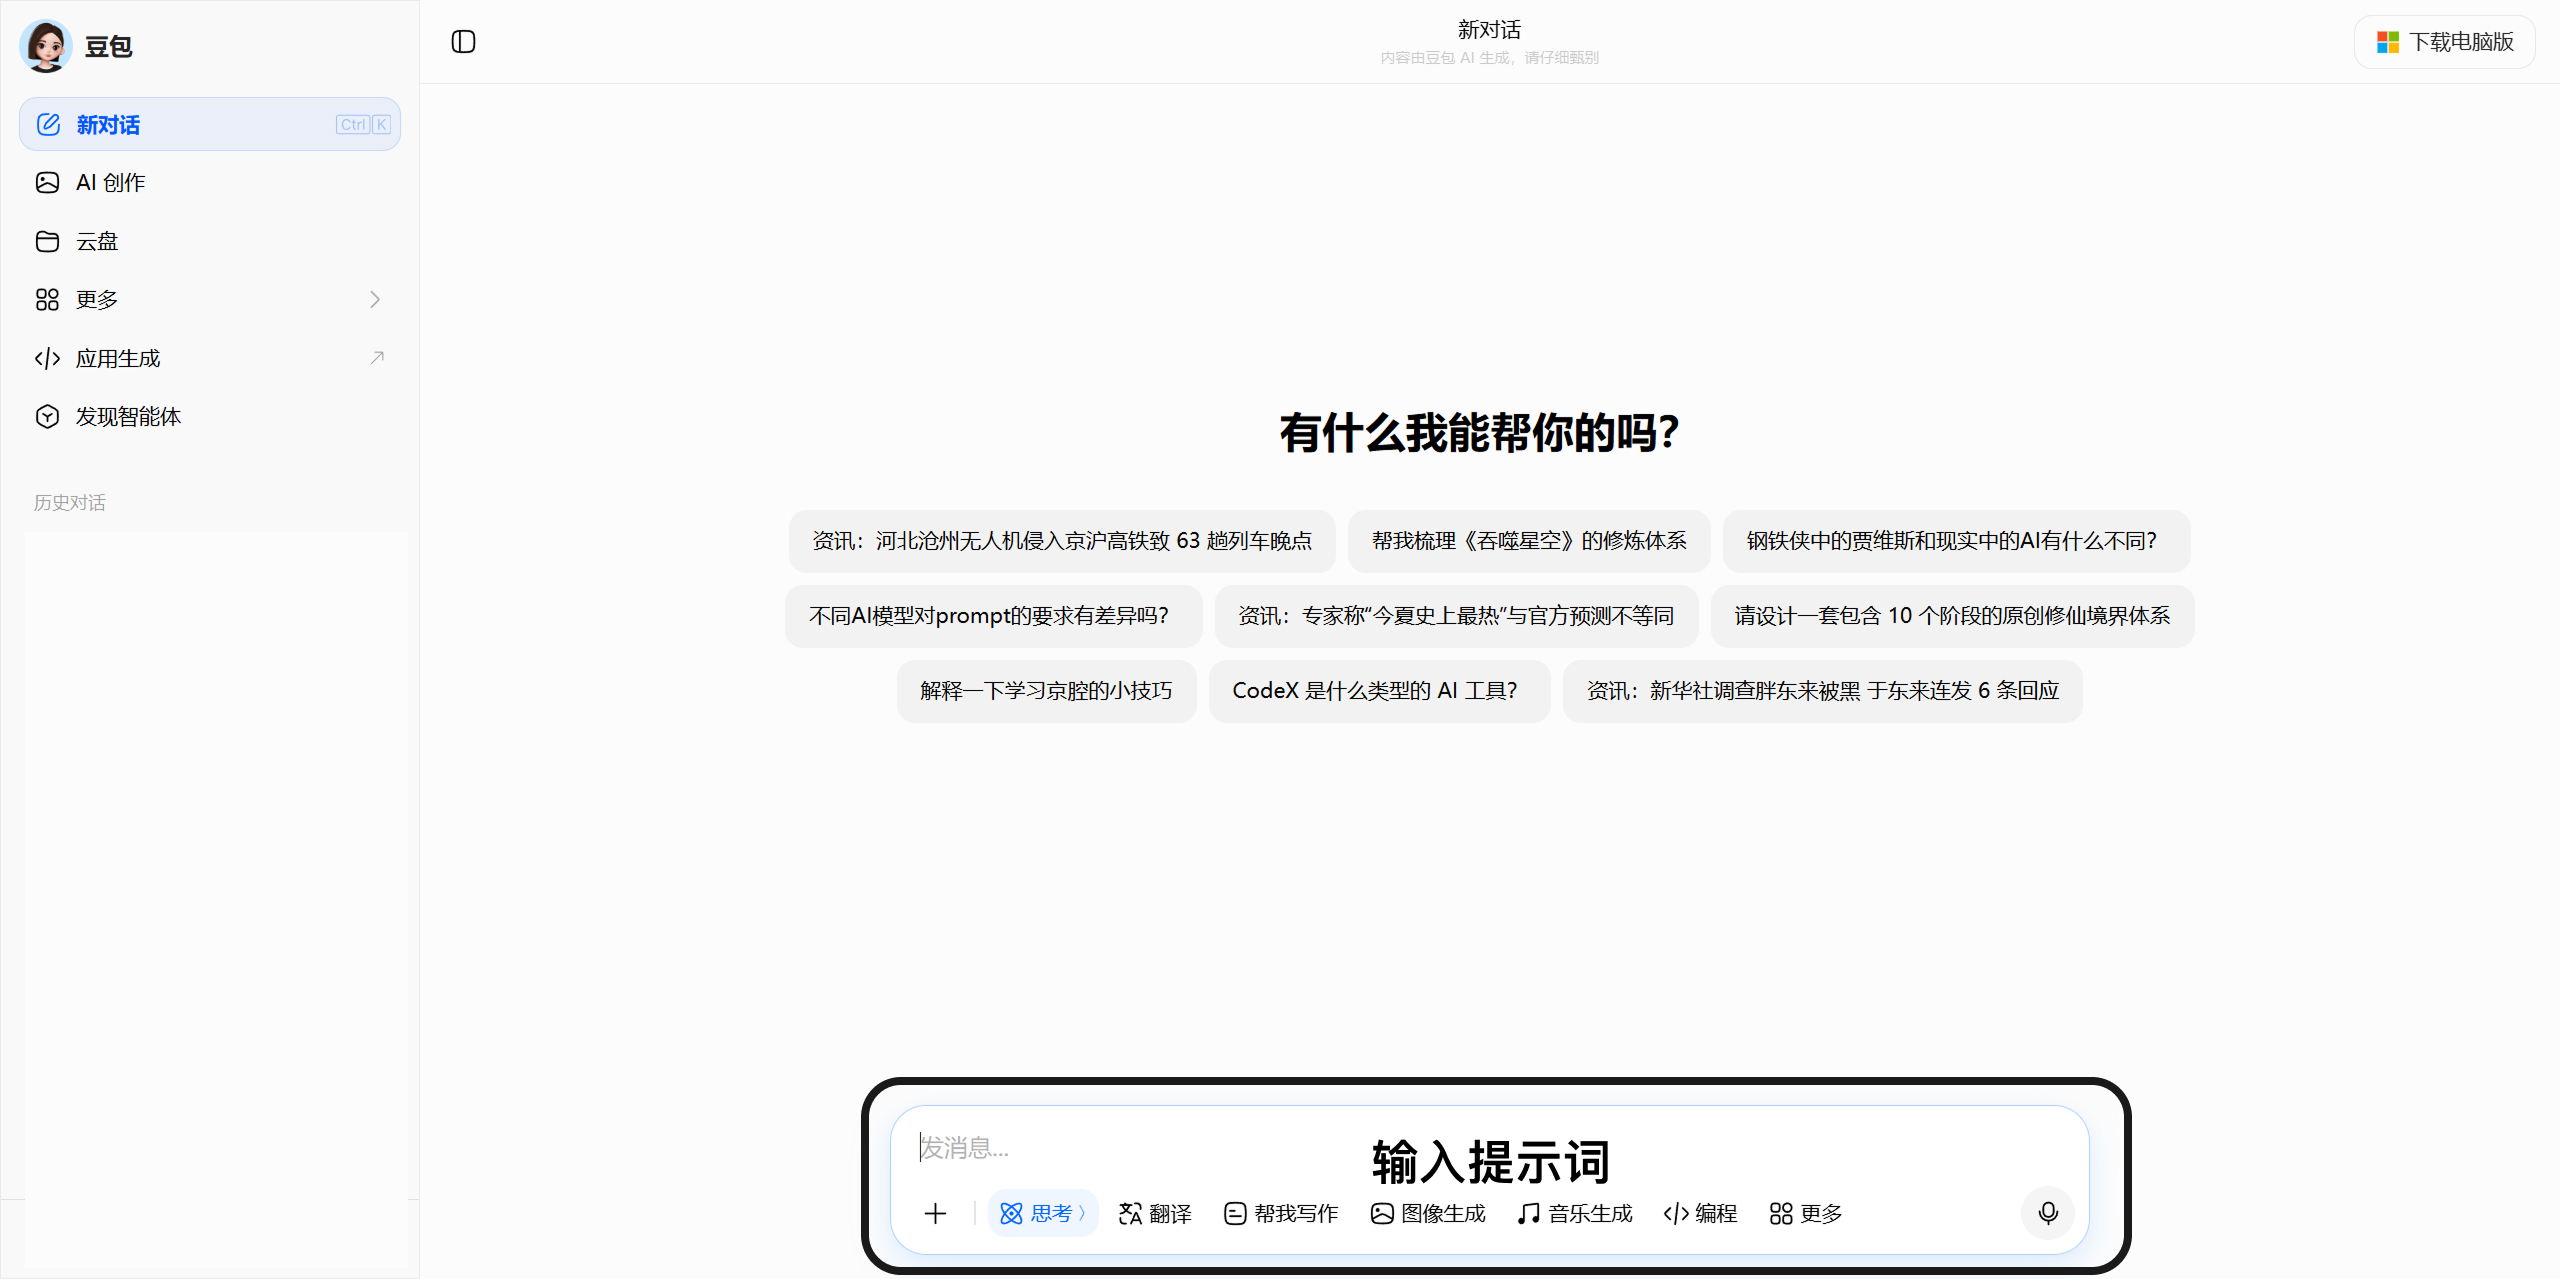
适合做什么:
中文写作、短视频脚本、小红书文案、学习辅导、图片视频生成、PPT/文档任务,也可以做生成式 AI 创作,例如批量内容选题、角色设定、故事策划、商业创意方案。
语言大模型使用案例:
1. 设计视频分镜
在使用可灵、即梦 Seedance、Veo 这类视频工具前,可以先让语言大模型帮你拆成多个镜头。
示例:
请把这个视频主题拆成 5 个分镜:主题是“普通人如何用 AI 提高工作效率”。每个分镜包括画面描述、镜头运动、字幕和旁白。
2. 优化图片和视频提示词
如果第一次生成的图片或视频效果不好,可以让语言大模型帮你优化提示词。
示例:
这张图的问题是画面太乱、标题不突出。请帮我重新优化提示词,让画面更简洁,标题区域更明显,适合做教程封面。
3. 批量生成内容选题
做自媒体、课程、社群内容时,可以让语言大模型批量生成选题。
示例:
请帮我生成 20 个适合 AI 小白的内容选题,方向包括 AI 写作、AI 绘画、AI 视频、AI 工具测评,每个标题要适合小红书发布。
4. 生成角色设定和故事设定
如果你想做 AI 短剧、AI 动画或系列内容,可以先用语言大模型设定人物、世界观和剧情。
示例:
请帮我设计一个 AI 科普短视频 IP,主角是一位 AI 小白和一位 AI 助手。请给出人物设定、内容风格、栏目名称和 10 期选题。
二、图片类工具
图片工具的核心不是“会不会画画”,而是你能不能把脑子里的画面说清楚。这也就是AI提示词(prompt)
1. Nano Banana 2 / Nano Banana Pro
Nano banana玩法 :https://www.super-i.cn/info-2651.html
官方工具入口1:
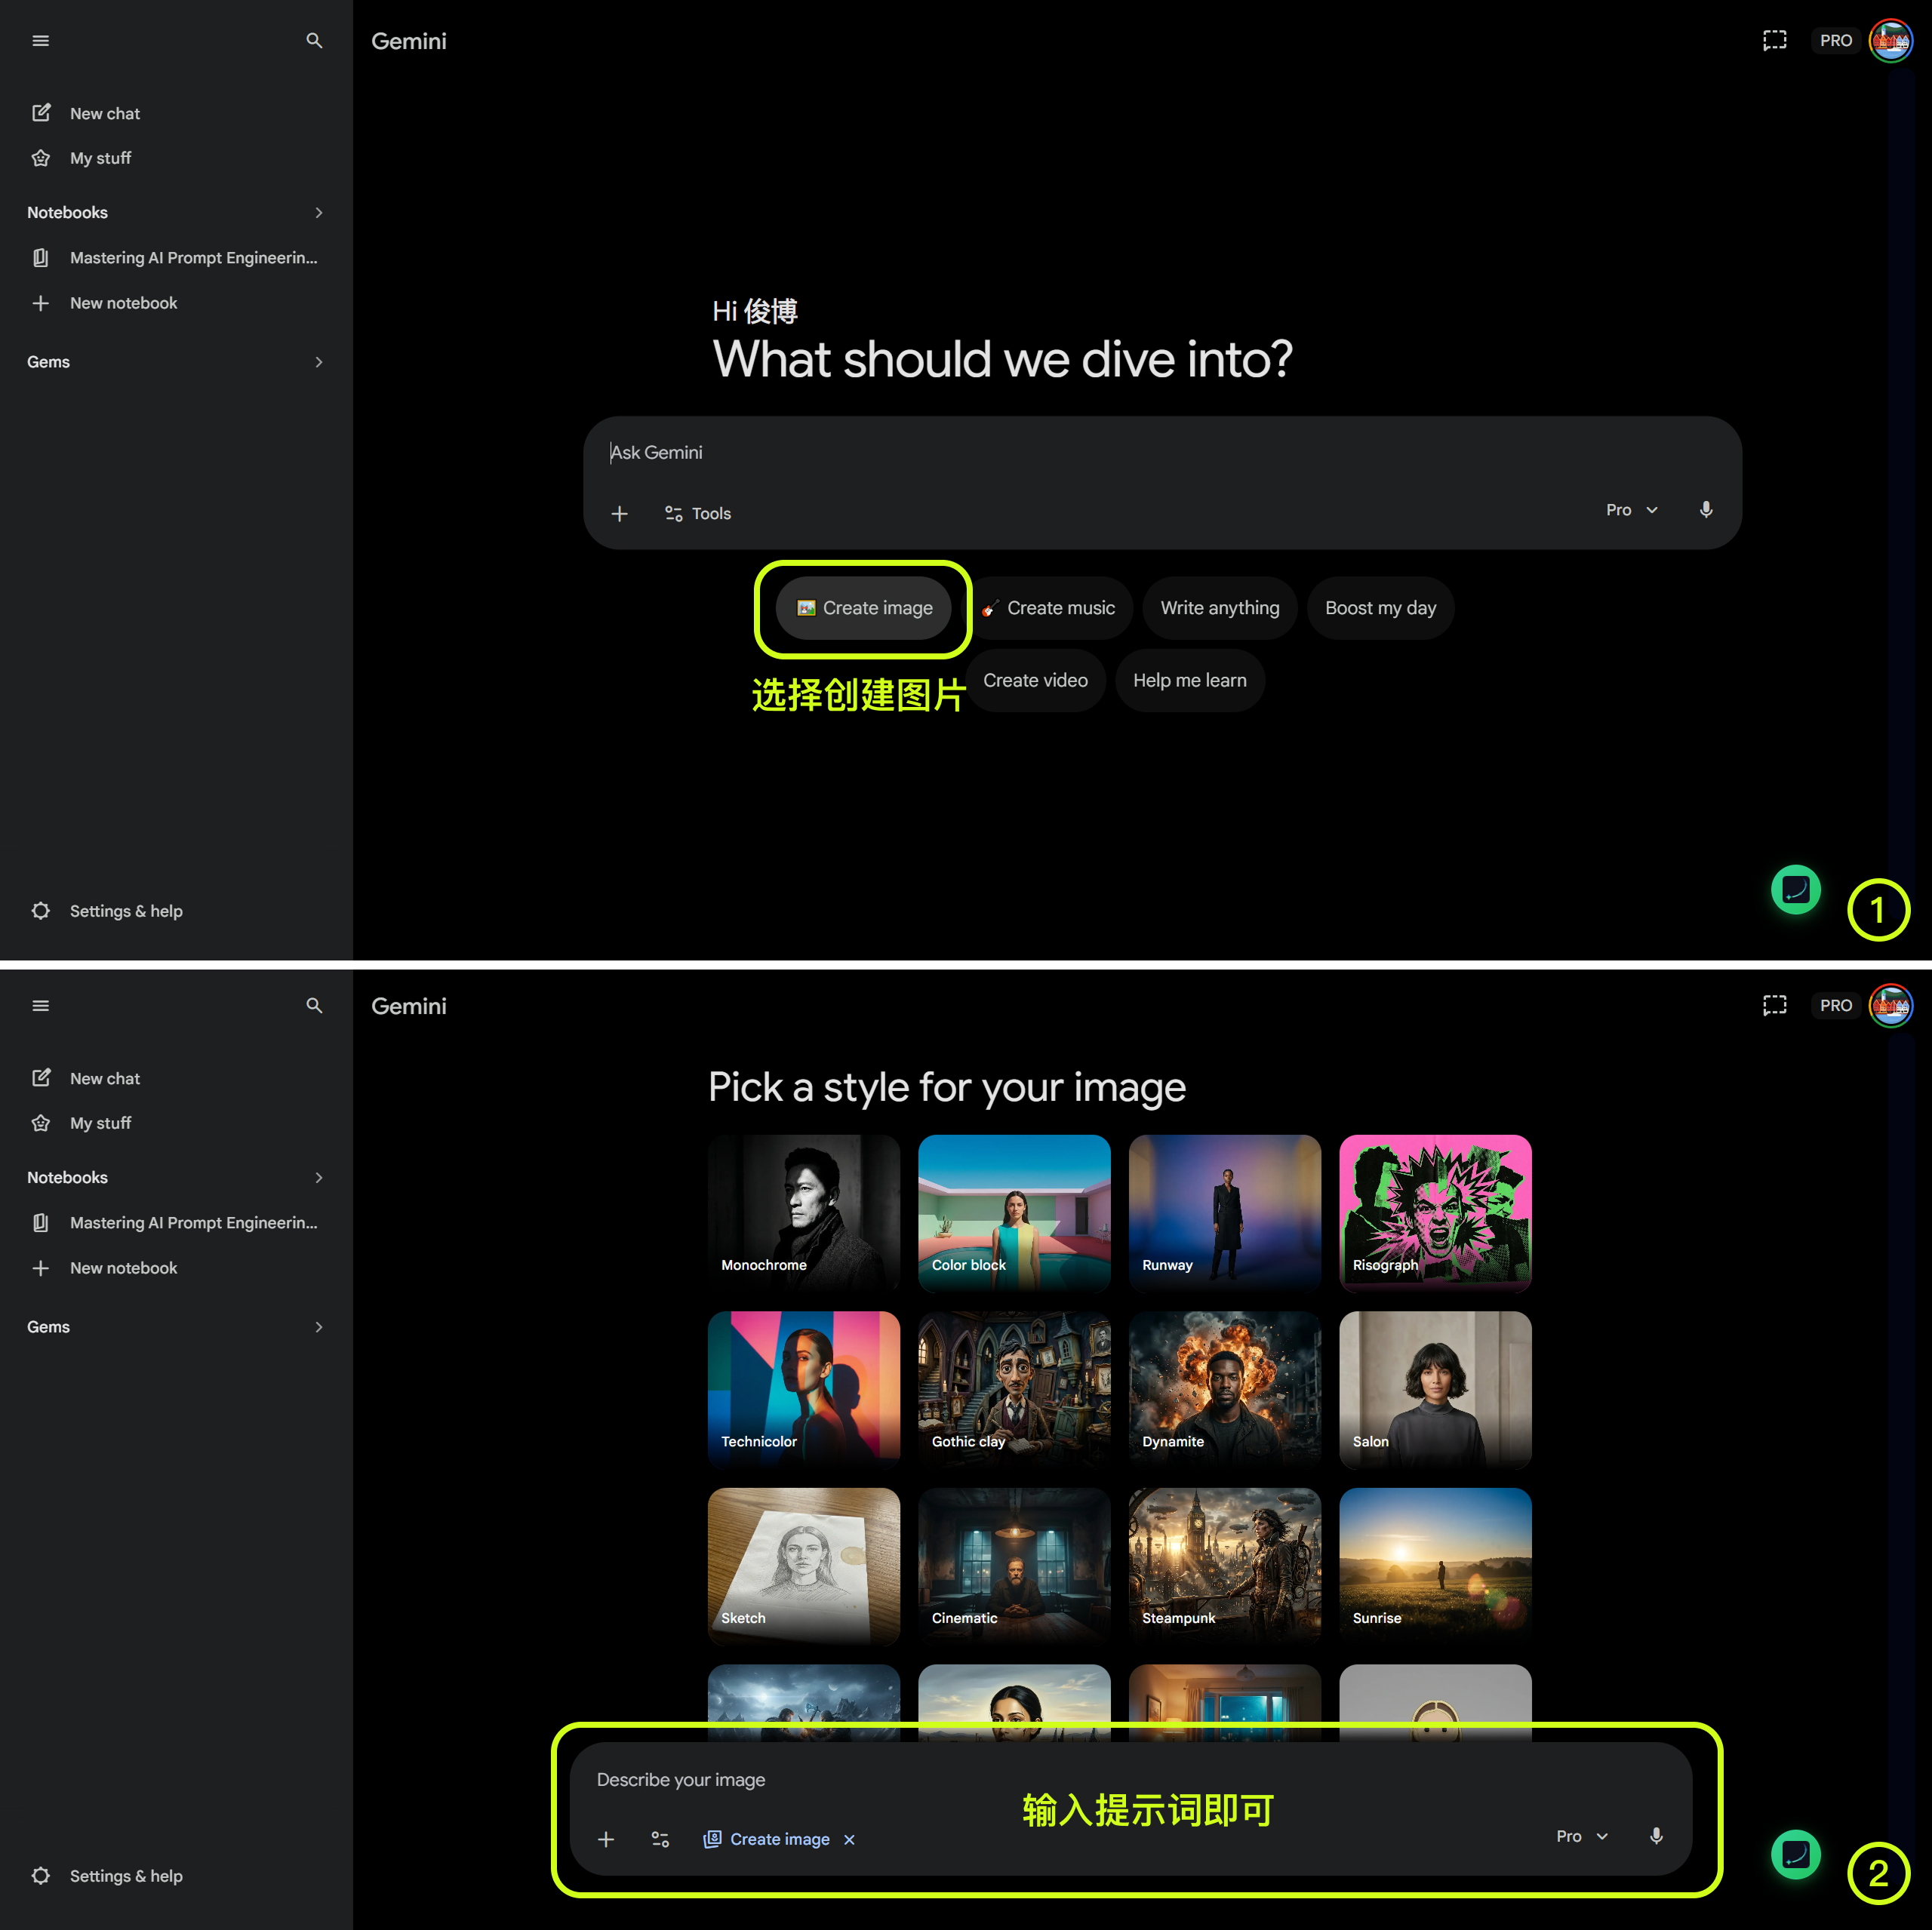
入口2:Flow(https://labs.google/fx/tools/flow/)
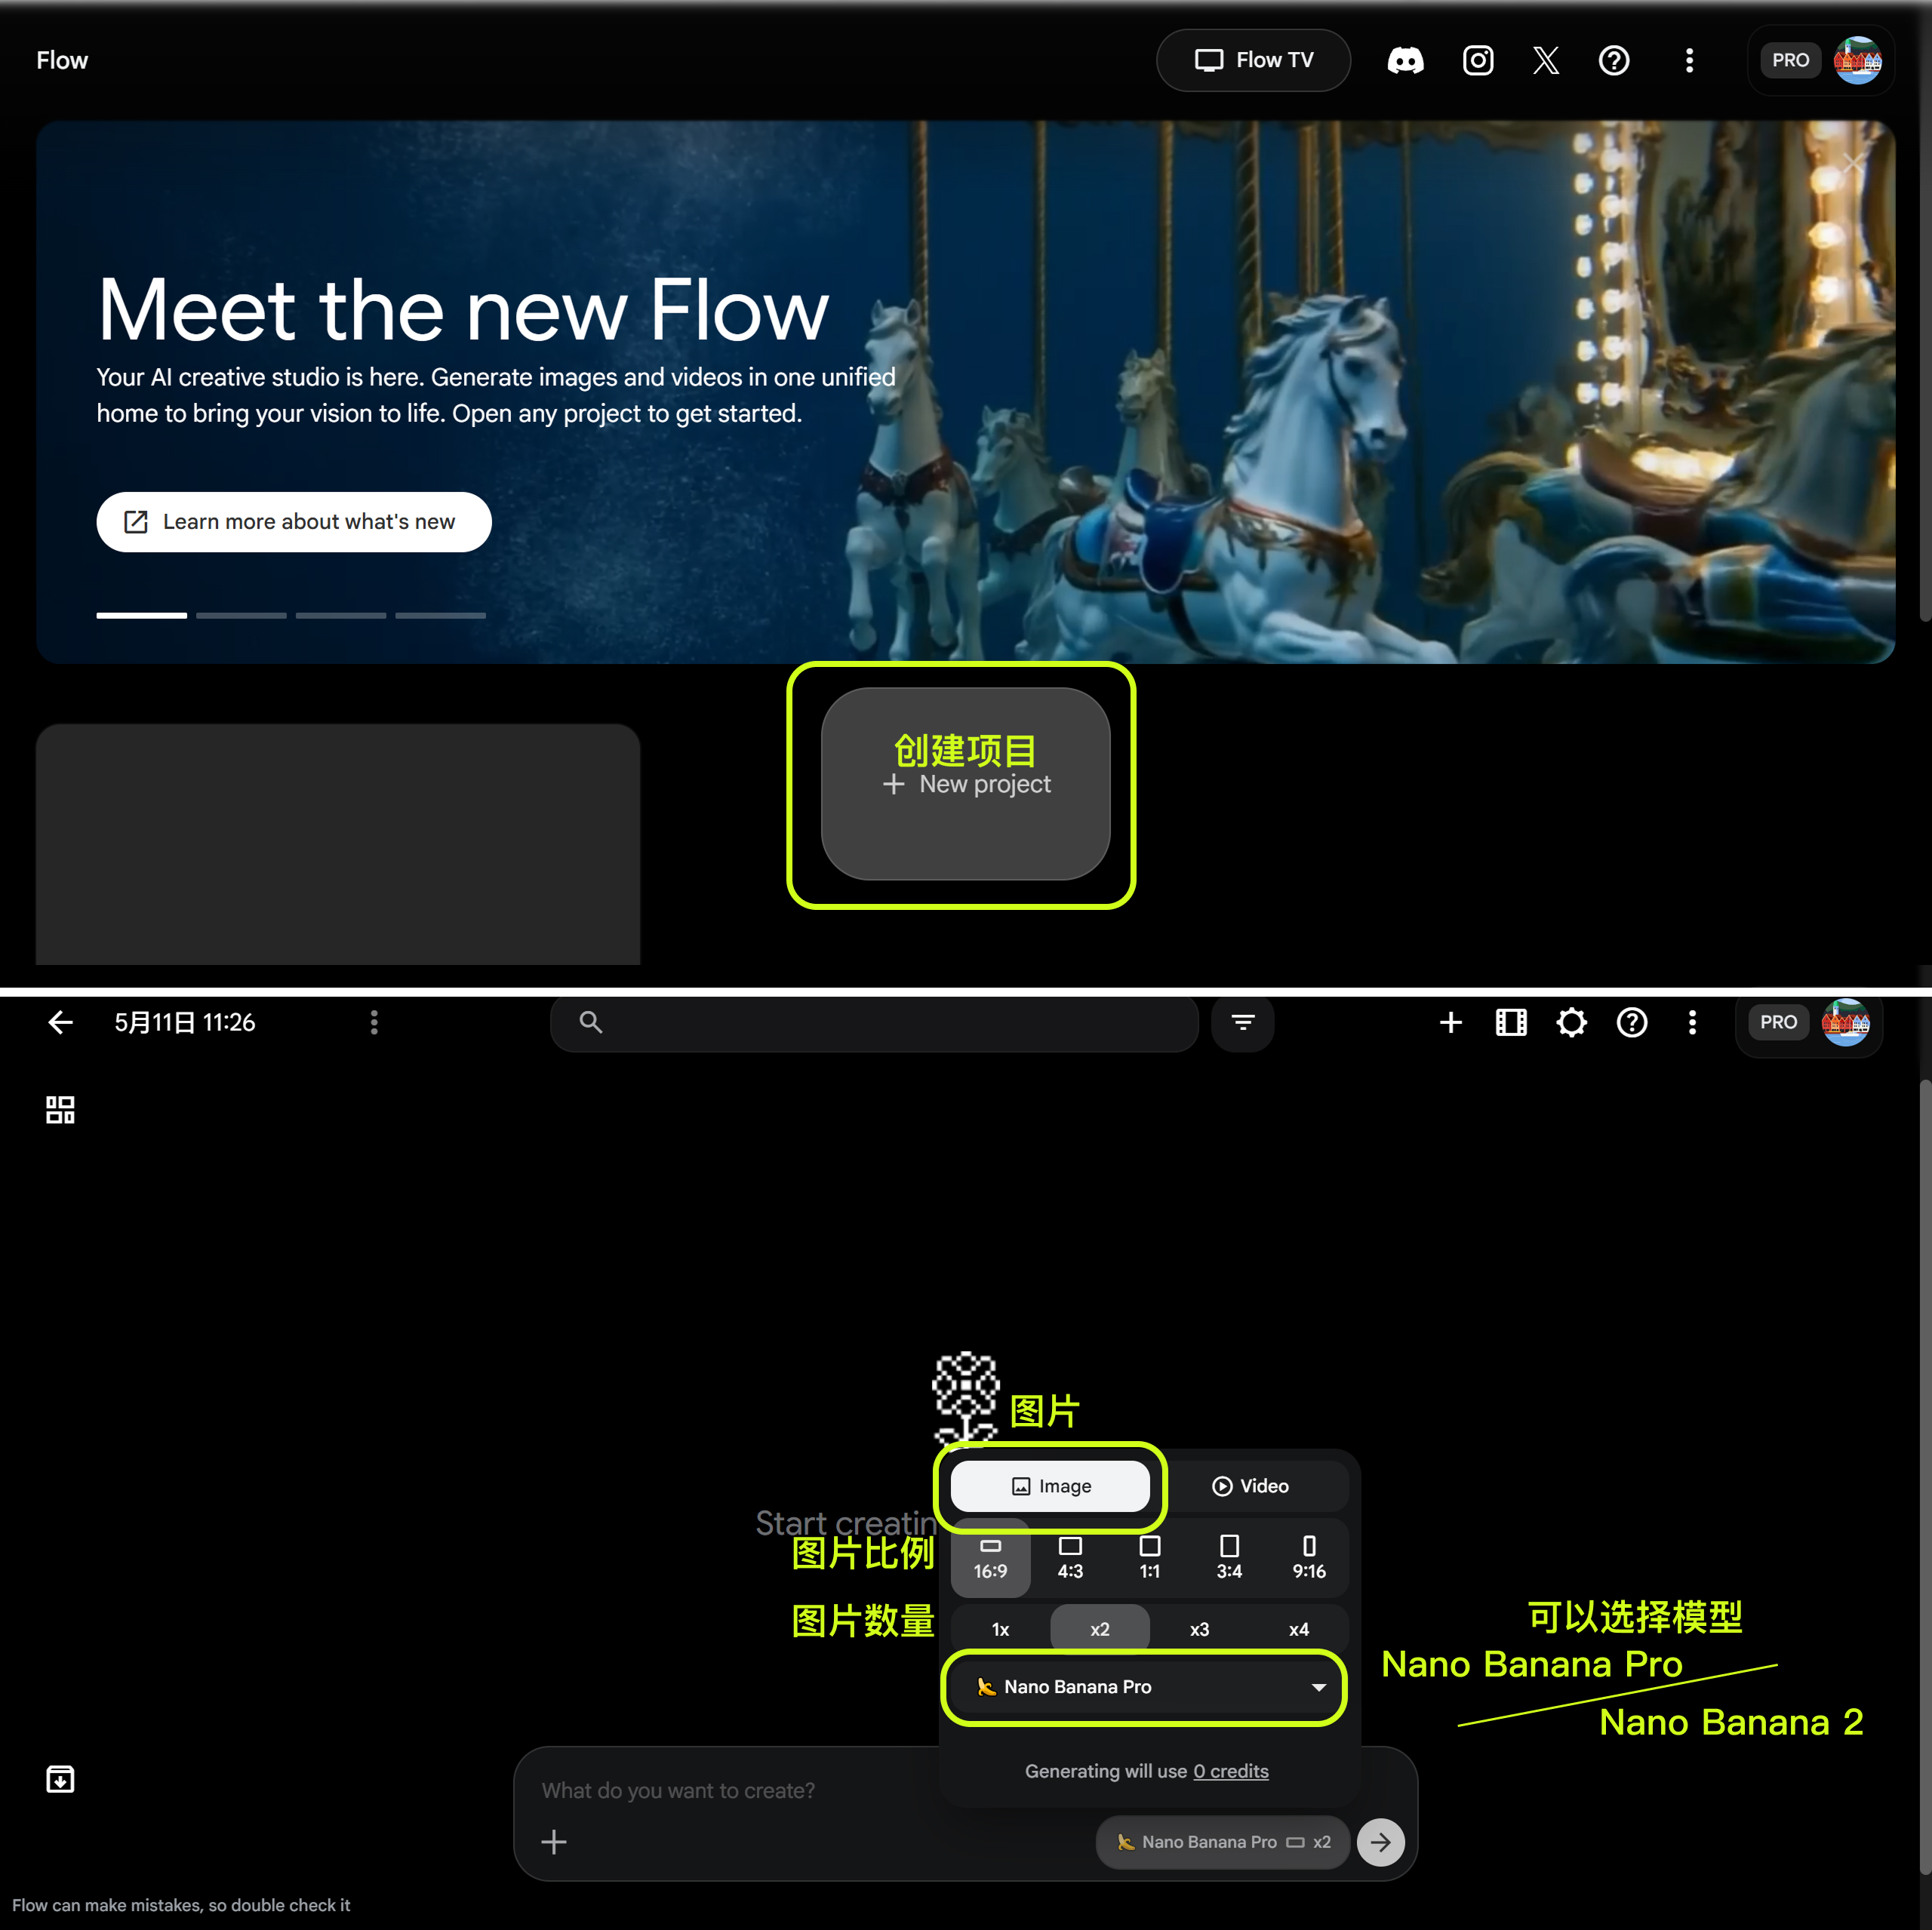
Nano Banana 2 主打速度、质量和规模化生成
Nano Banana Pro 则基于 Gemini 3 Pro Image,更强调推理能力、更加真实,真实世界知识、文字渲染和高精度视觉表达。
适合做什么:改图、插画、人物一致性图片、产品图、文字较清晰的设计图、参考图改图。
优势:
极强的提示词遵循能力,以及图片真实性,适合制作西方人
不足
艺术风格的“惊艳感”可能不如 Midjourney。
2. Image 2.0
Image 2.0玩法 :https://www.super-i.cn/info-2772.html
官方工具入口1:
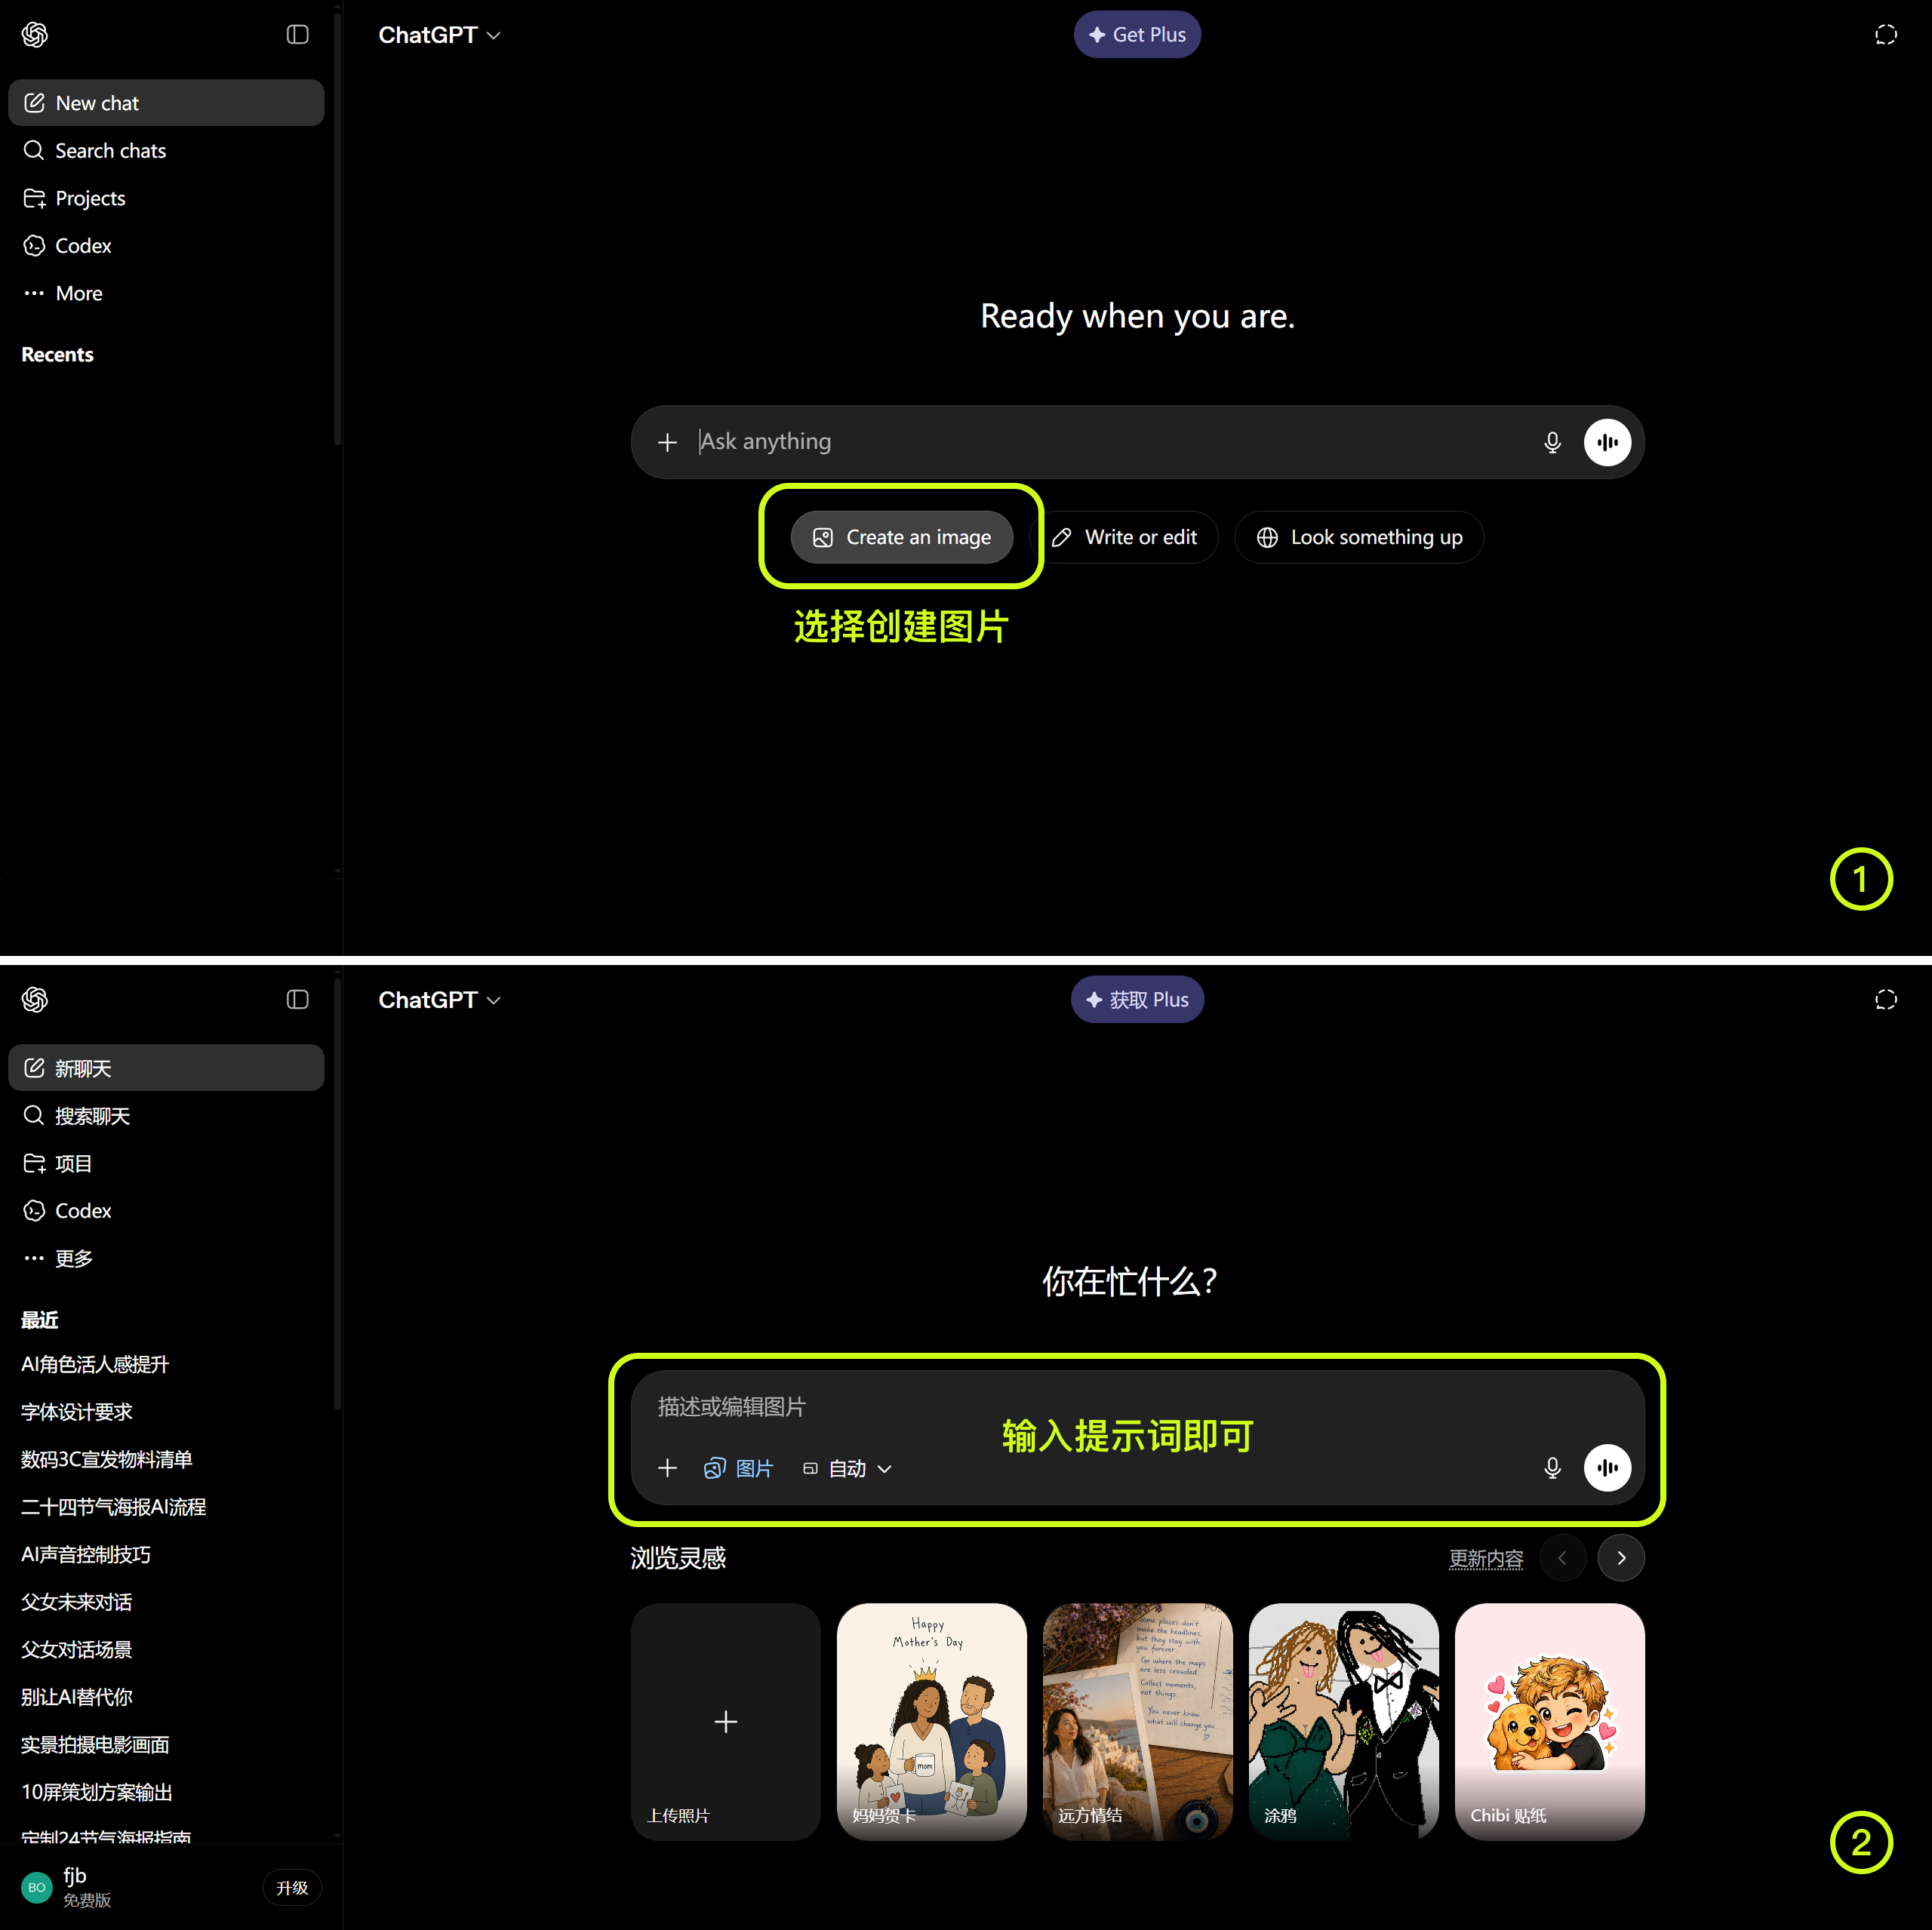
优点
第一:适合普通人用自然语言控制。
你不用写很复杂的绘画提示词,可以直接说:“帮我做一张 AI 工具教程封面,标题要醒目,风格要适合小白。”
第二:目前最强的图片文字生成与排版(详情可以看 Image 2.0玩法)
不足
如果追求极强艺术风格,Midjourney 可能更有优势。
有时候的图片人物会比较的油腻
3. Midjourney
官方工具入口:
https://www.midjourney.com/explore?tab=top
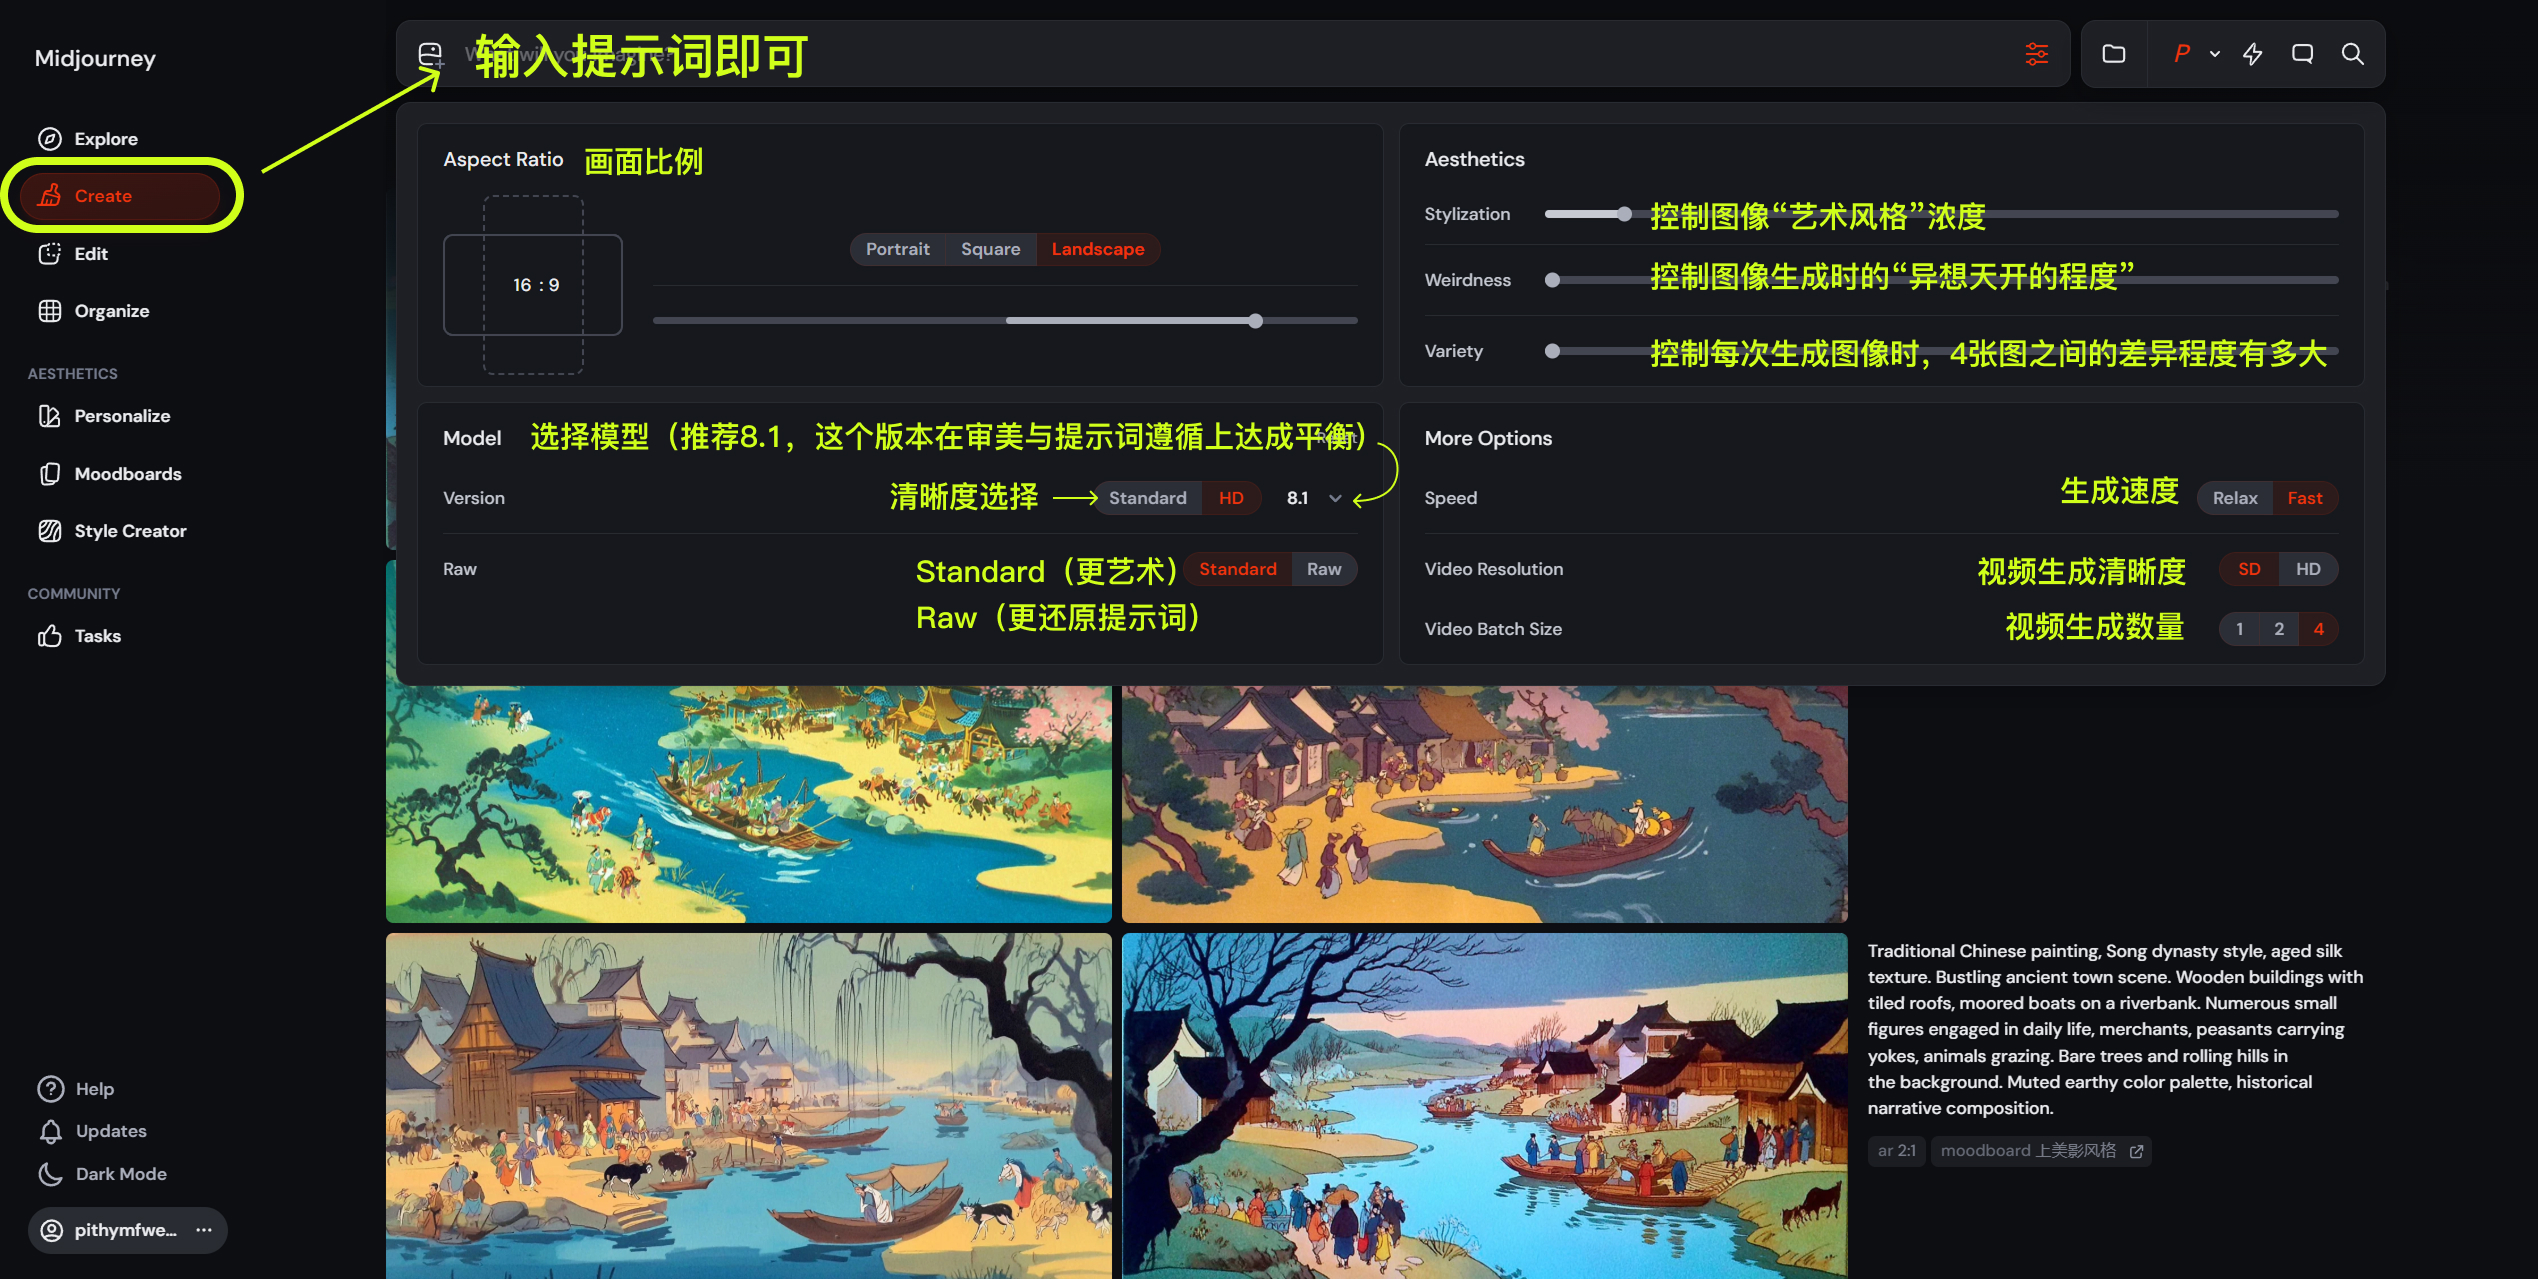
优点:
第一,审美强。
Midjourney 很适合做“看起来高级”的图,尤其是插画、概念图、电影感、时尚摄影、幻想风格。
第二,风格化能力强。
如果你想要赛博朋克、复古胶片、欧美杂志、电影海报、奇幻世界观,Midjourney 往往很容易出效果。
第三,适合做灵感图。
品牌视觉、IP 形象、海报方向、场景氛围图,都可以先用 Midjourney 找感觉。
不足:
对小白来说,上手门槛略高。
中文文字生成和复杂排版不是它的强项。
如果需要严格按照标题、文案、版式生成 Image 或 Nano Banana 可能更适合。
4. 即梦 Seedream
官方工具入口:
https://jimeng.jianying.com/ai-tool/generate?type=image&workspace=undefined
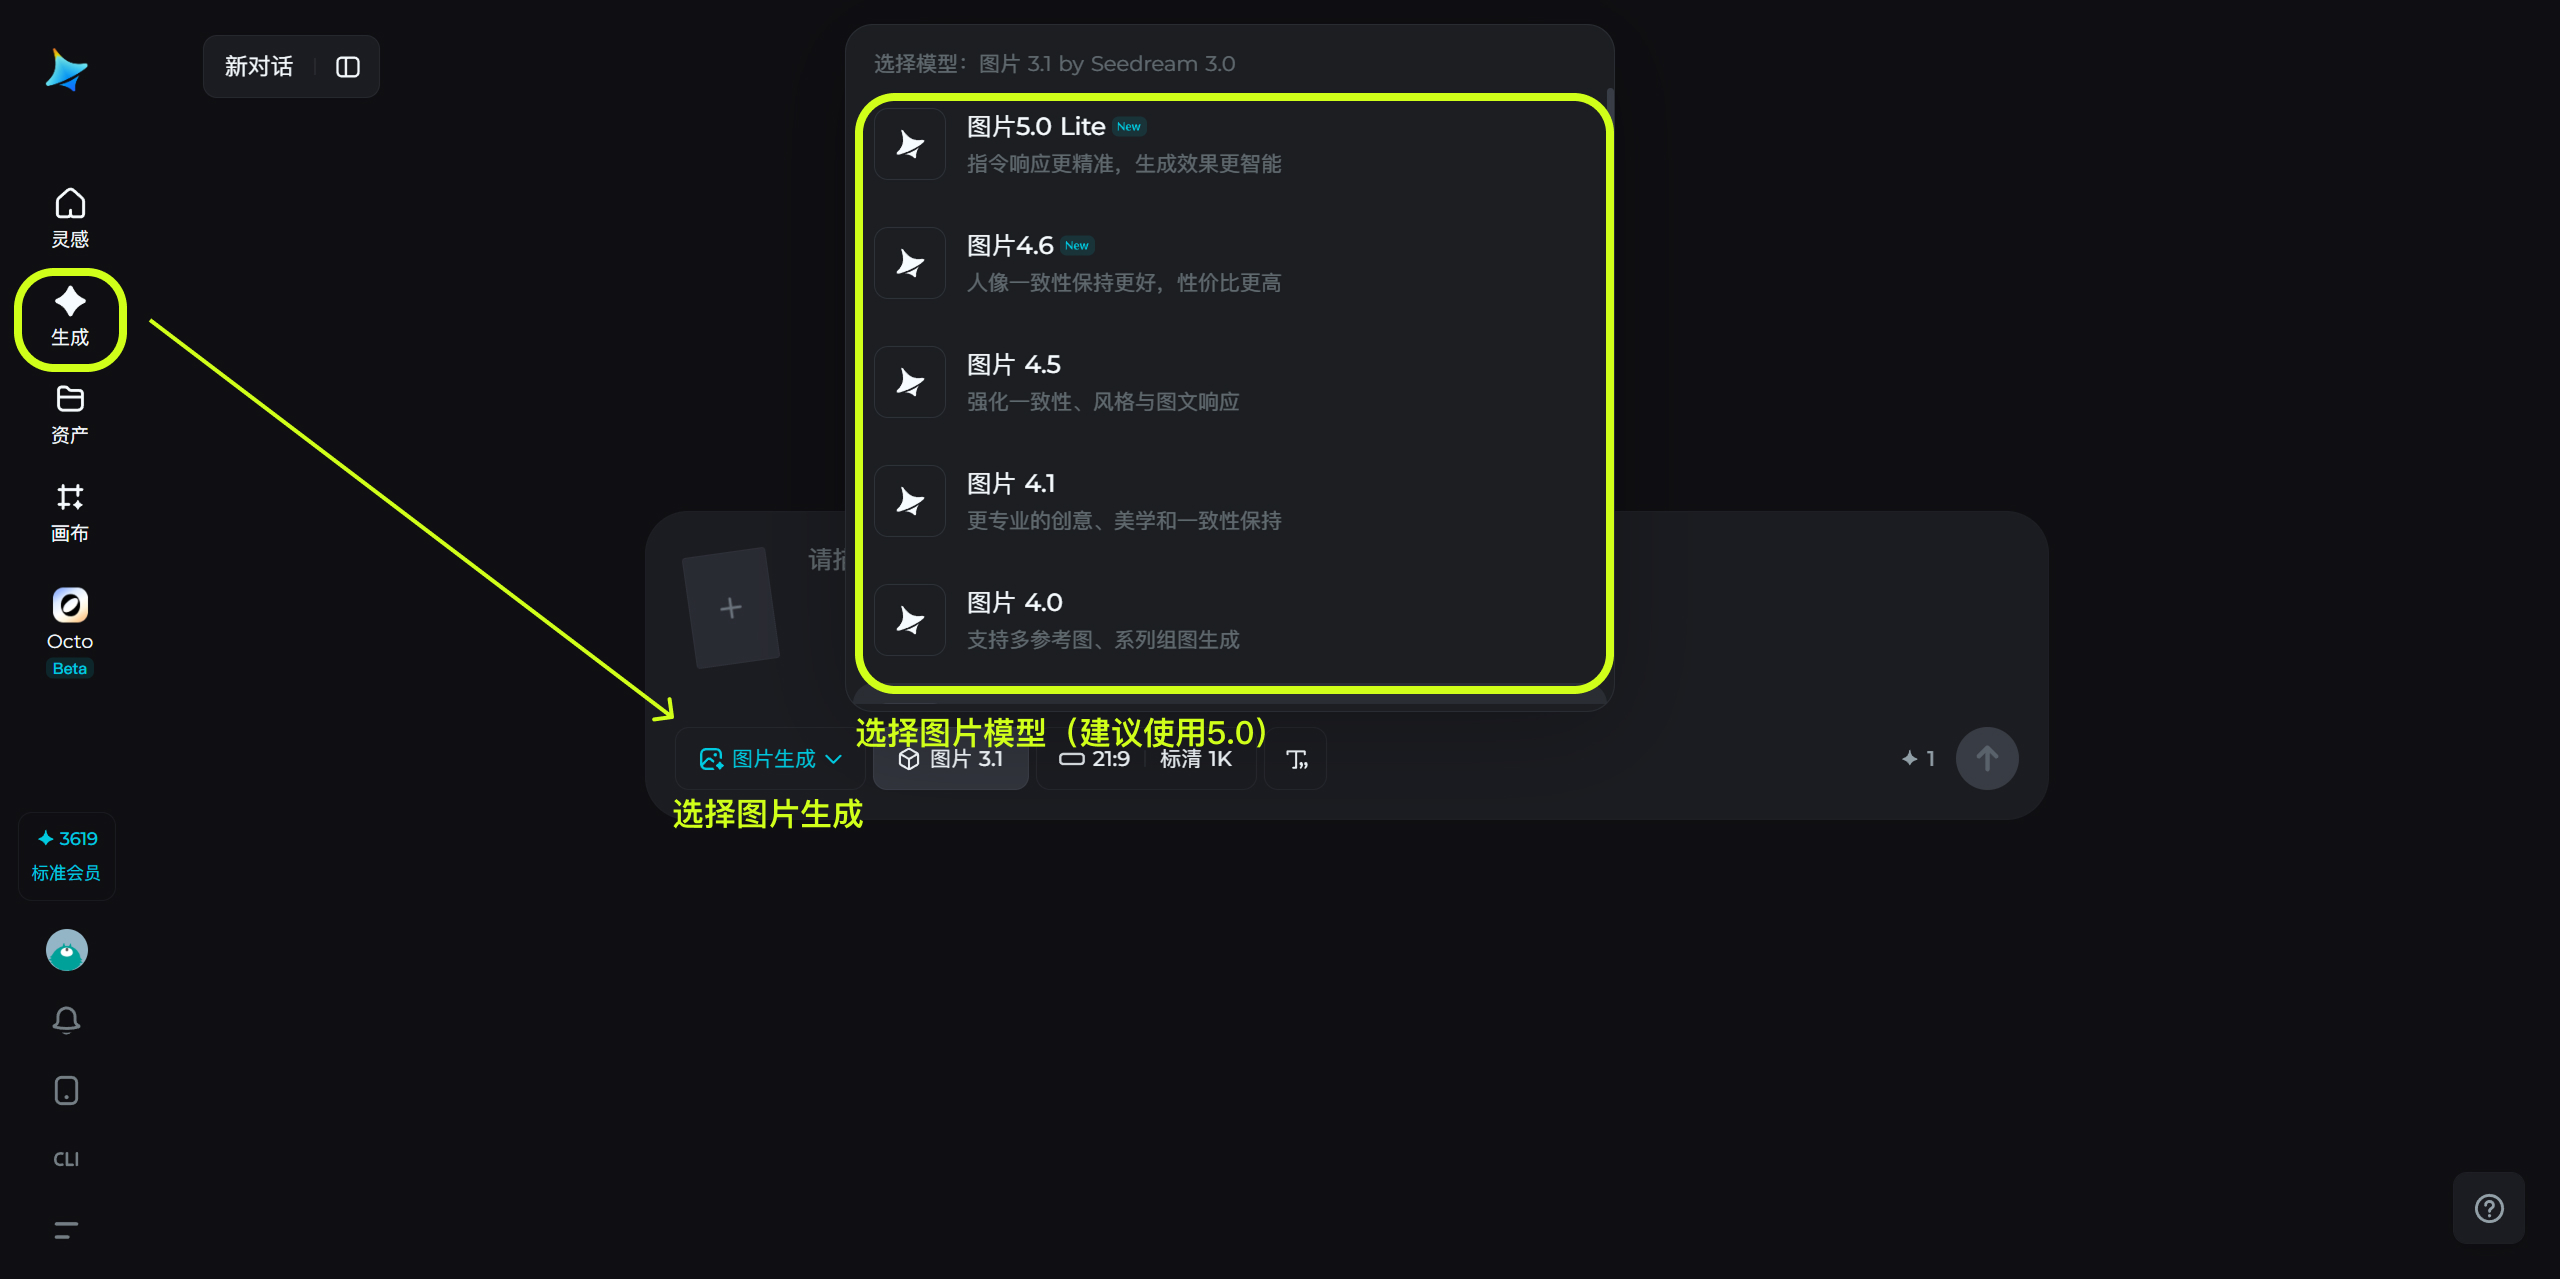
优点
第一,对中文用户友好。
即梦本身就是中文创作者常用入口之一,适合直接用中文描述画面。生成的人物形象比较符合中国人审美
第二,改图能力实用。
它不只是“从零生成图片”,还适合做背景替换、局部修改、人物保持、风格转换、扩图等操作。
不足
极致艺术审美和风格化表现,不如 Midjourney 。
文字生成的效果也比较一般。
总体来说是“青春版中国特化版nanobanan”
三、视频类工具
目前用的最多的就是可灵3.0和即梦seedance2.0,也是现在最推荐的俩个视频生成模型。
1. 可灵 Kling AI
官方入口:
https://klingai.com/app/omni/new?ac=1
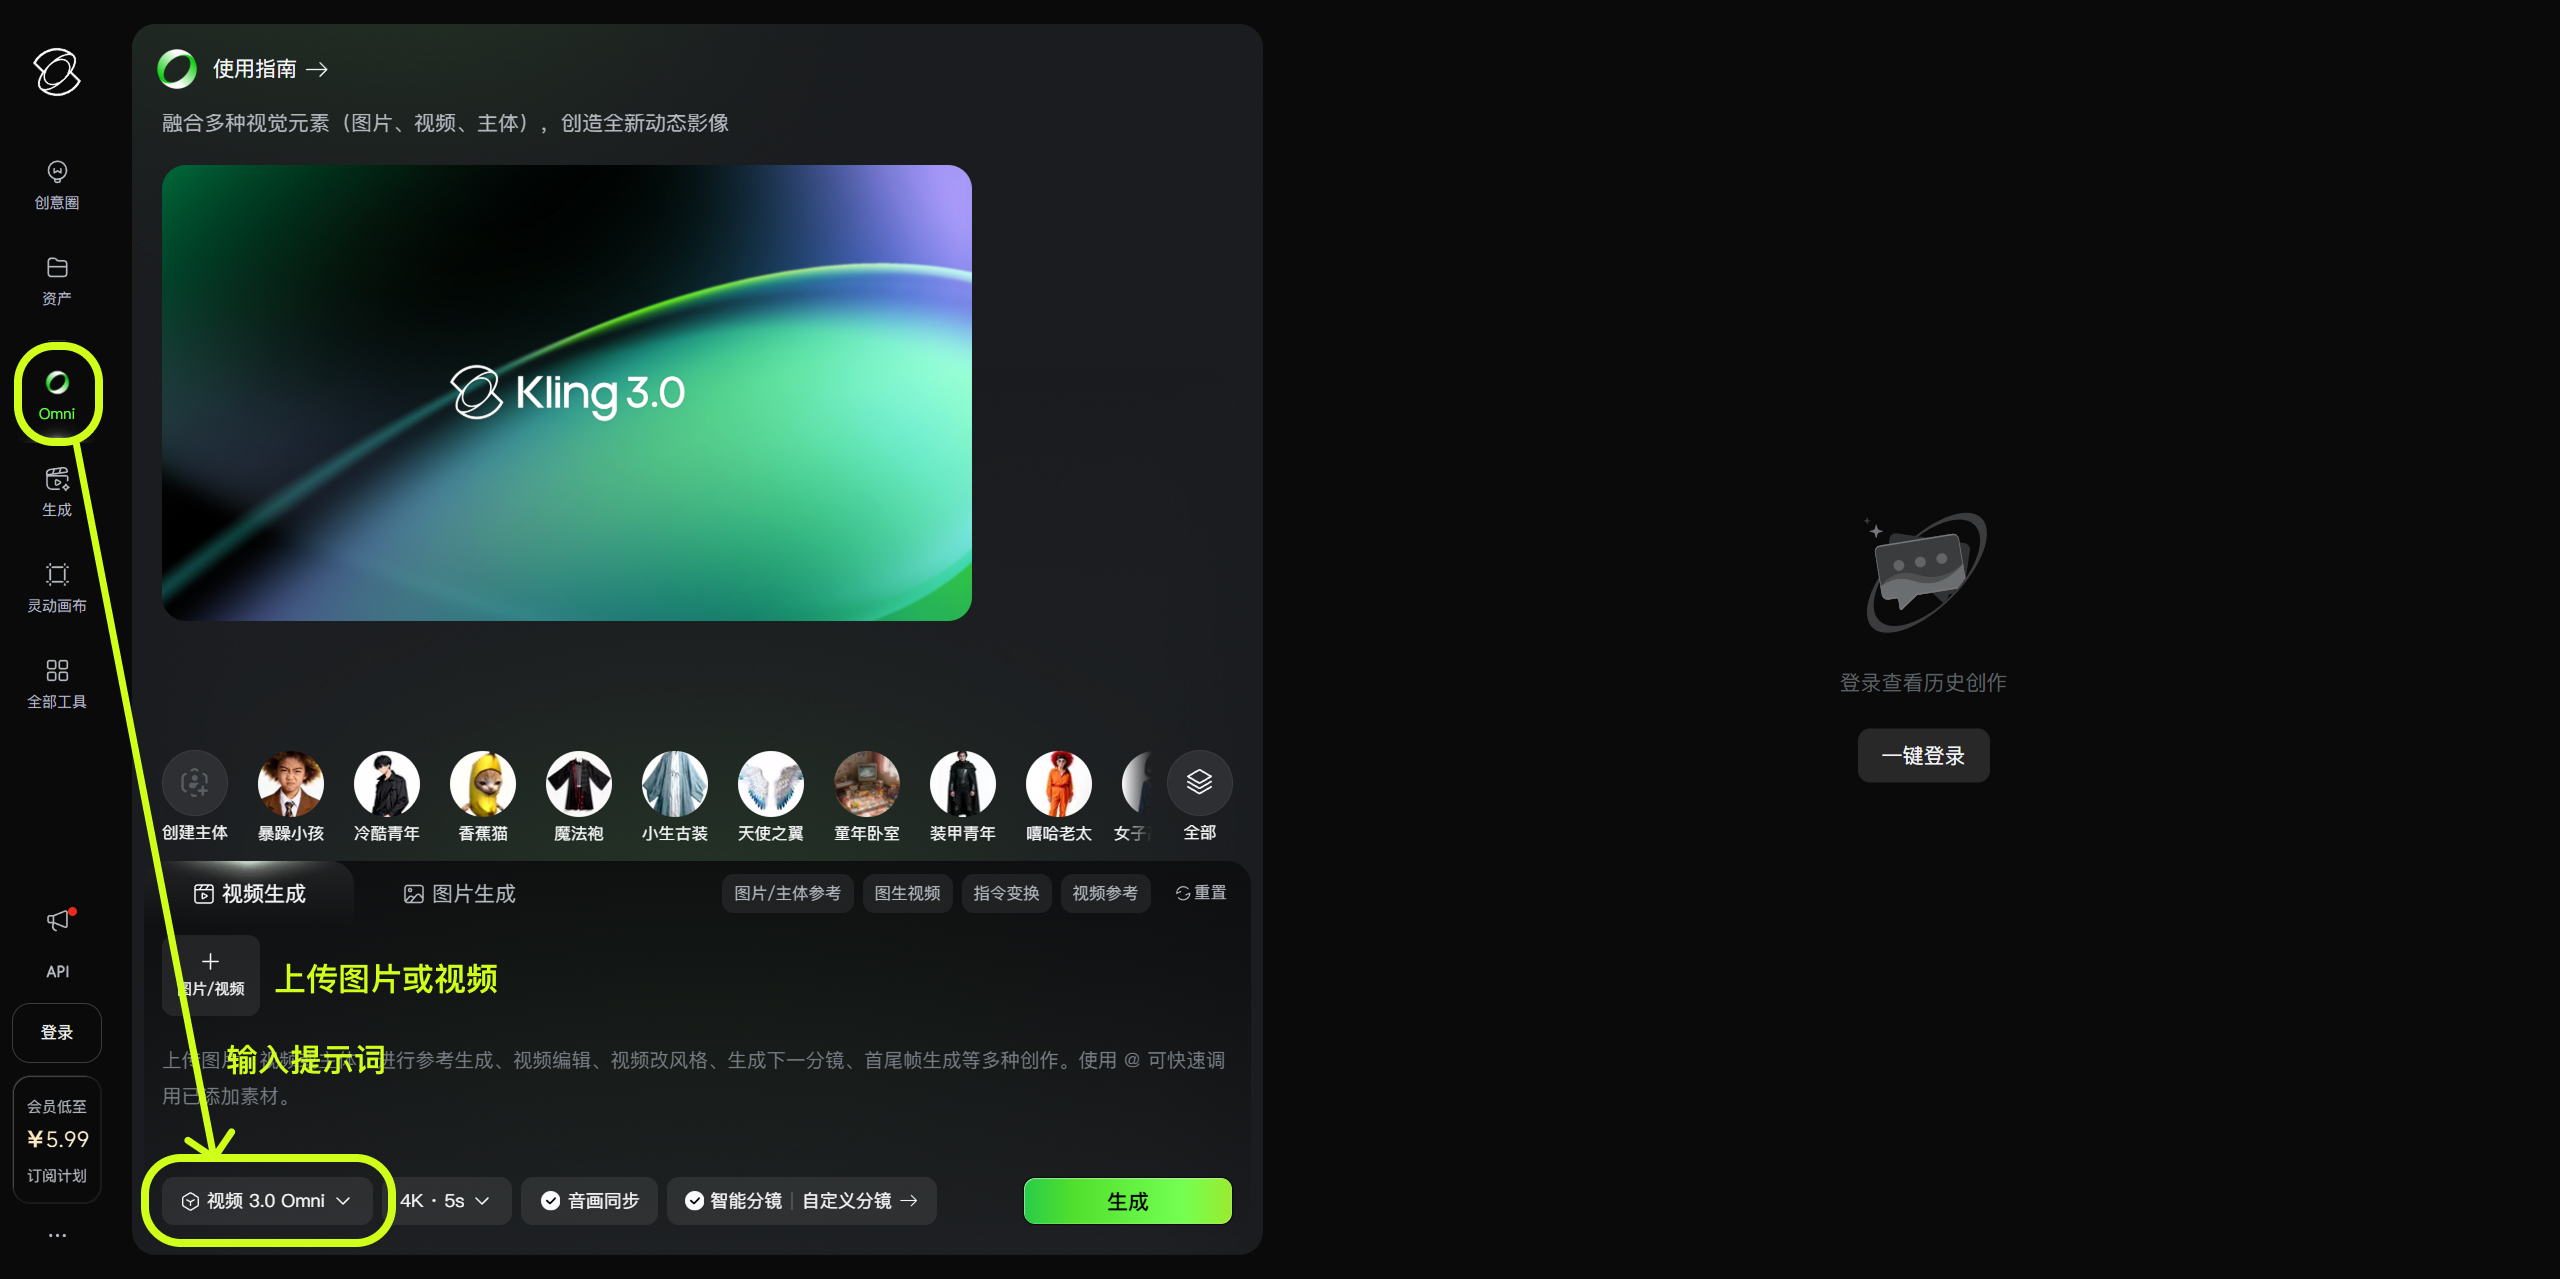
核心特点
导演级控制:支持多镜头/多场景叙事,可以把一段脚本分成多个镜头一起生成。
强角色一致性:通过 Omni 参考系统,指定角色/对象的外观并跨镜头保持一致。
原生音频同步:生成带有声音、对白、环境音的视频,不需要后期配音。
镜头运动控制:可以精细指定镜头运动和摄影效果(例如推进、环绕、拉远等)。
多模态输入:支持从文字或图像生成,还能读参考图像生成动态过渡。
长度弹性:可生成 3–15 秒视频(或更长片段通过衔接实现)。
清晰度爆表(但也贵的爆表):最新支持4k直出,相比于AI超清的,画质无敌。
2. 即梦 Seedance
官方入口1:即梦AI
https://jimeng.jianying.com/ai-tool/generate?type=video&workspace=undefined
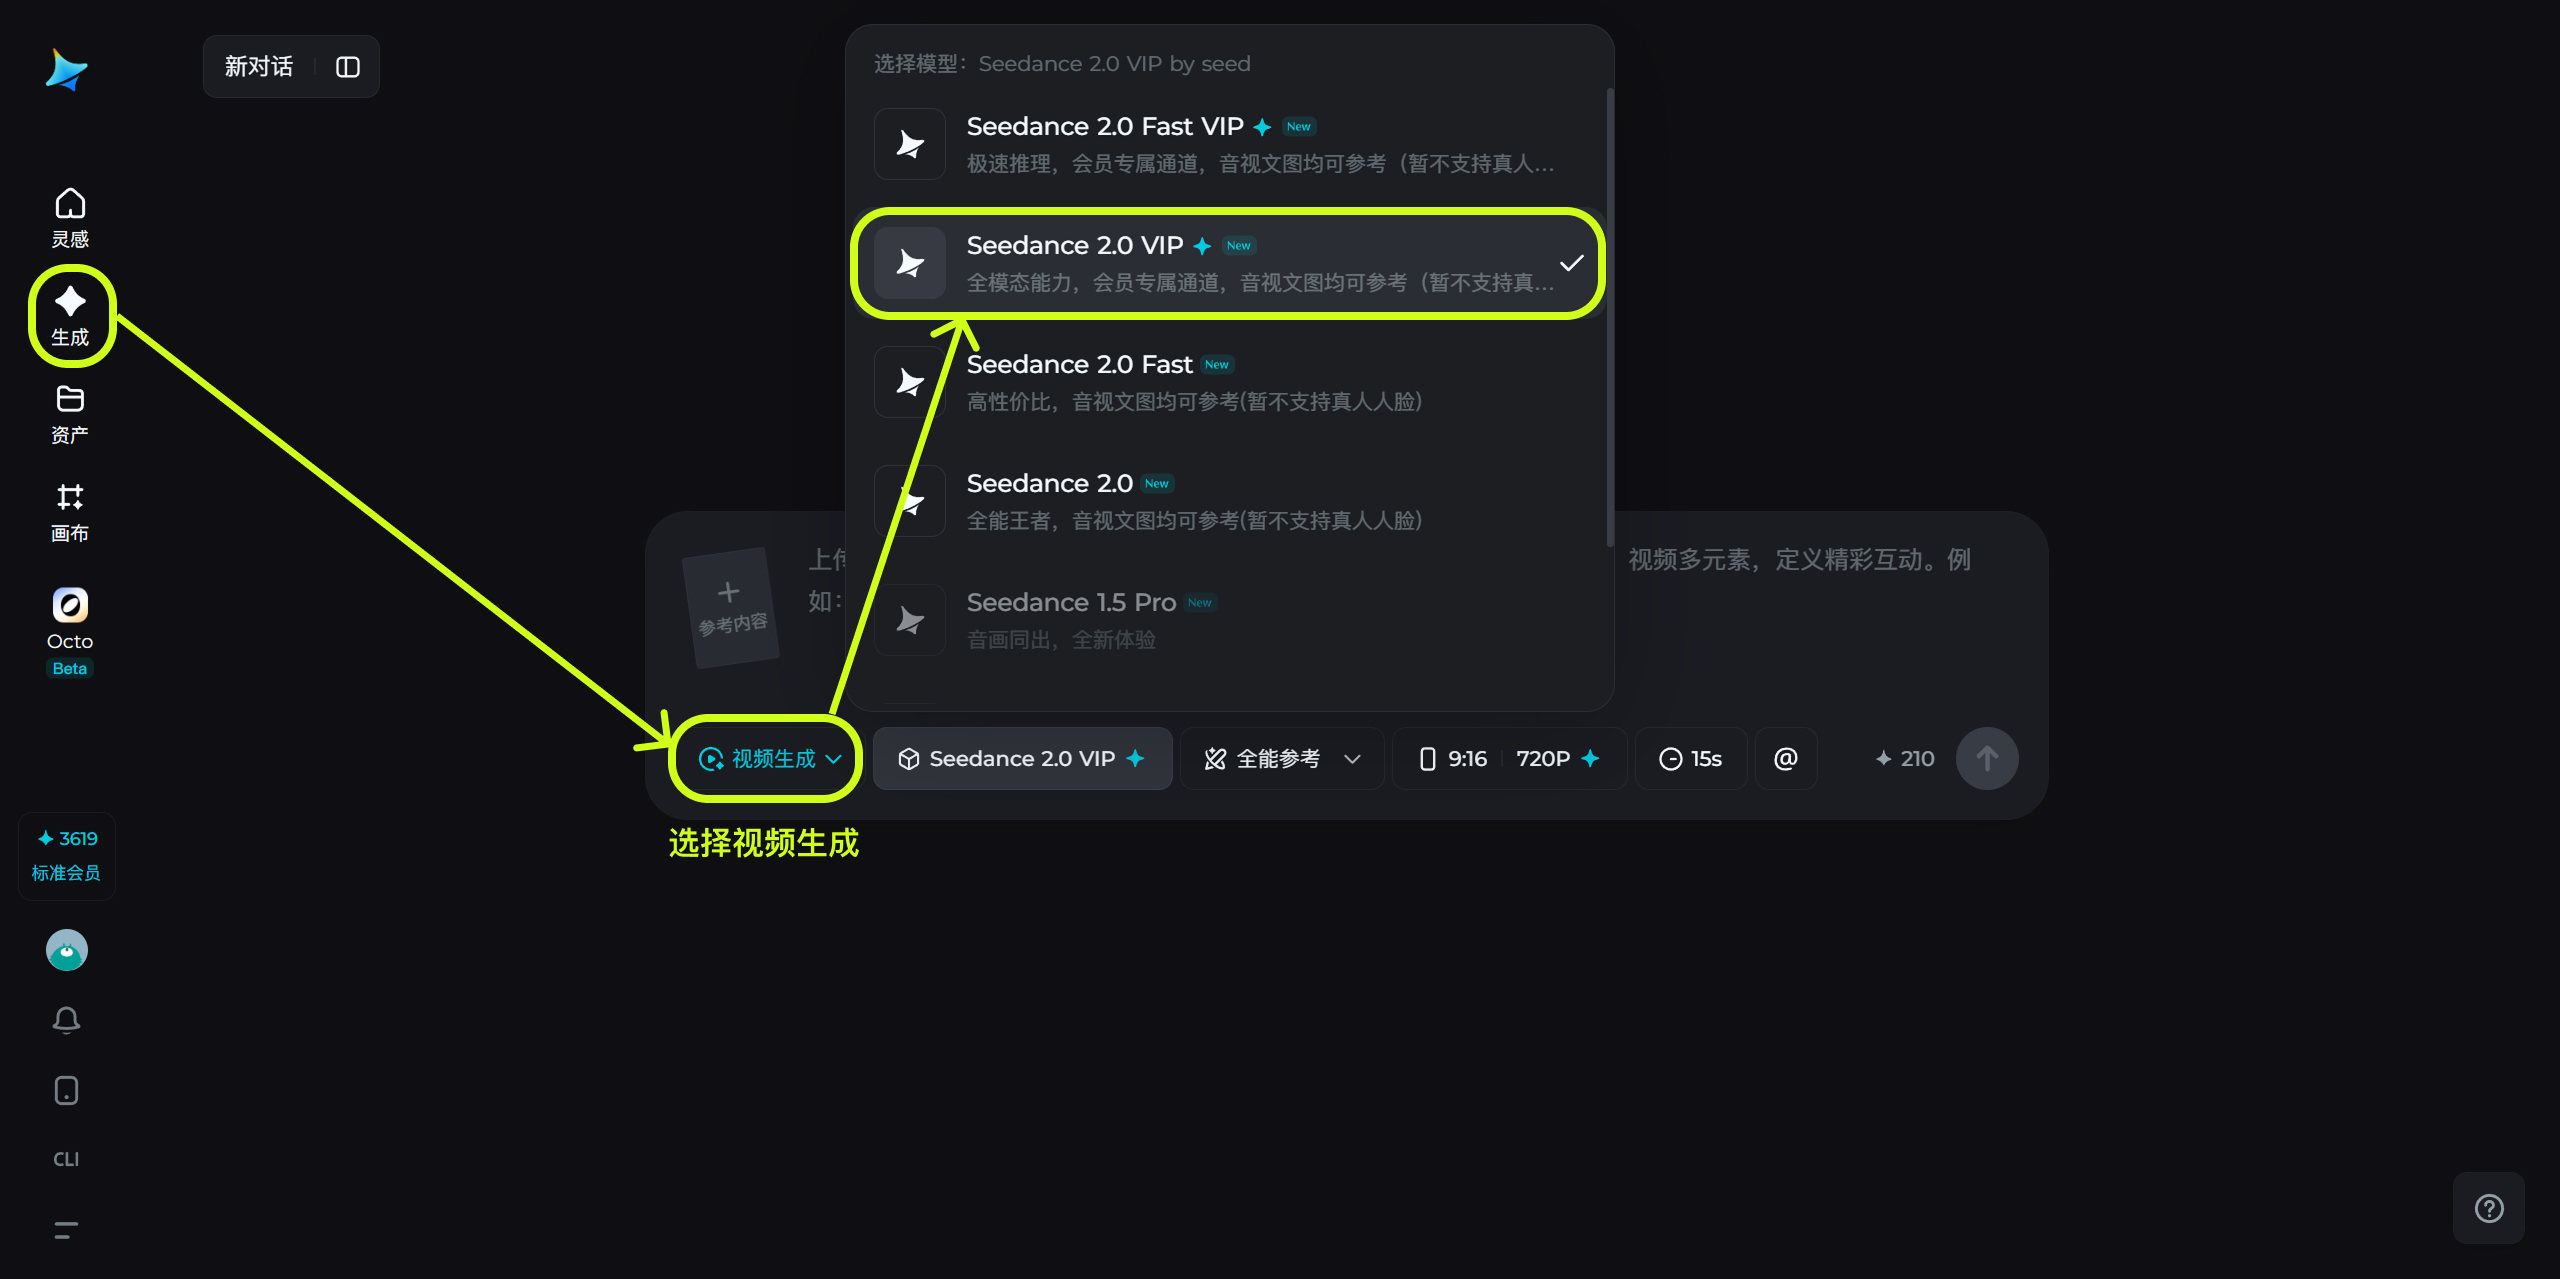
官方入口2:小云雀 https://xyq.jianying.com/home?from_page=xiaoyunque_landing_page&tab_name=home
对比与可灵3.0 Omni,seedance2.0生成更加合理,且真实。对于提示词的遵循程度也大于可灵。(唯一的缺点就是贵!!)
特点:
2.1.真实世界复杂度生成
物理真实性:严格遵循真实世界运动规律,显著改善人体运动建模的自然度、时序连贯性
2.2.强大的多模态能力
全面输入:支持文本、图像、视频、音频组合输入(最多3个视频、9张图像、3段音频)
导演推理:具备基础的导演和摄影推理能力,可自主规划镜头序列。
2.3.高保真音视频生成
双声道音频:支持沉浸式双声道音频生成 多轨输出:同时生成背景音、环境音、角色旁白,与视觉节奏精确对齐
2.4.生产力场景应用
支持商业广告、影视特效、游戏动画、解说视频等多场景 原生支持480p、720p、1080p分辨率,视频时长4-15秒
四、AI 聚合类 / 工作流平台
这一类工具不是单纯生成一张图或一段视频,而是把模型、画布、素材、脚本、分镜、批量生成、编辑流程整合在一起。适合做品牌视觉、广告片、社媒内容矩阵、课程素材包。
优势说明
一次上传,多平台复用:不需要每个工具都开会员,也不用反复上传同一素材。聚合平台可以在一个工作流里调动不同 AI 模型生成图片、视频、文本。
工作流复用:可以直接使用社区模板或已有流程,快速生成内容,再替换文字、图片或产品素材。
适合完整项目:品牌宣传、社媒系列内容、课程素材包等,可以在一个平台完成从构思到成品的全过程。
1. FlowPix
入口:FlowPix 官网。
适合做什么:工作流复用、品牌内容、社媒图片、电商视觉、海报、AI 图片/视频工作流学习
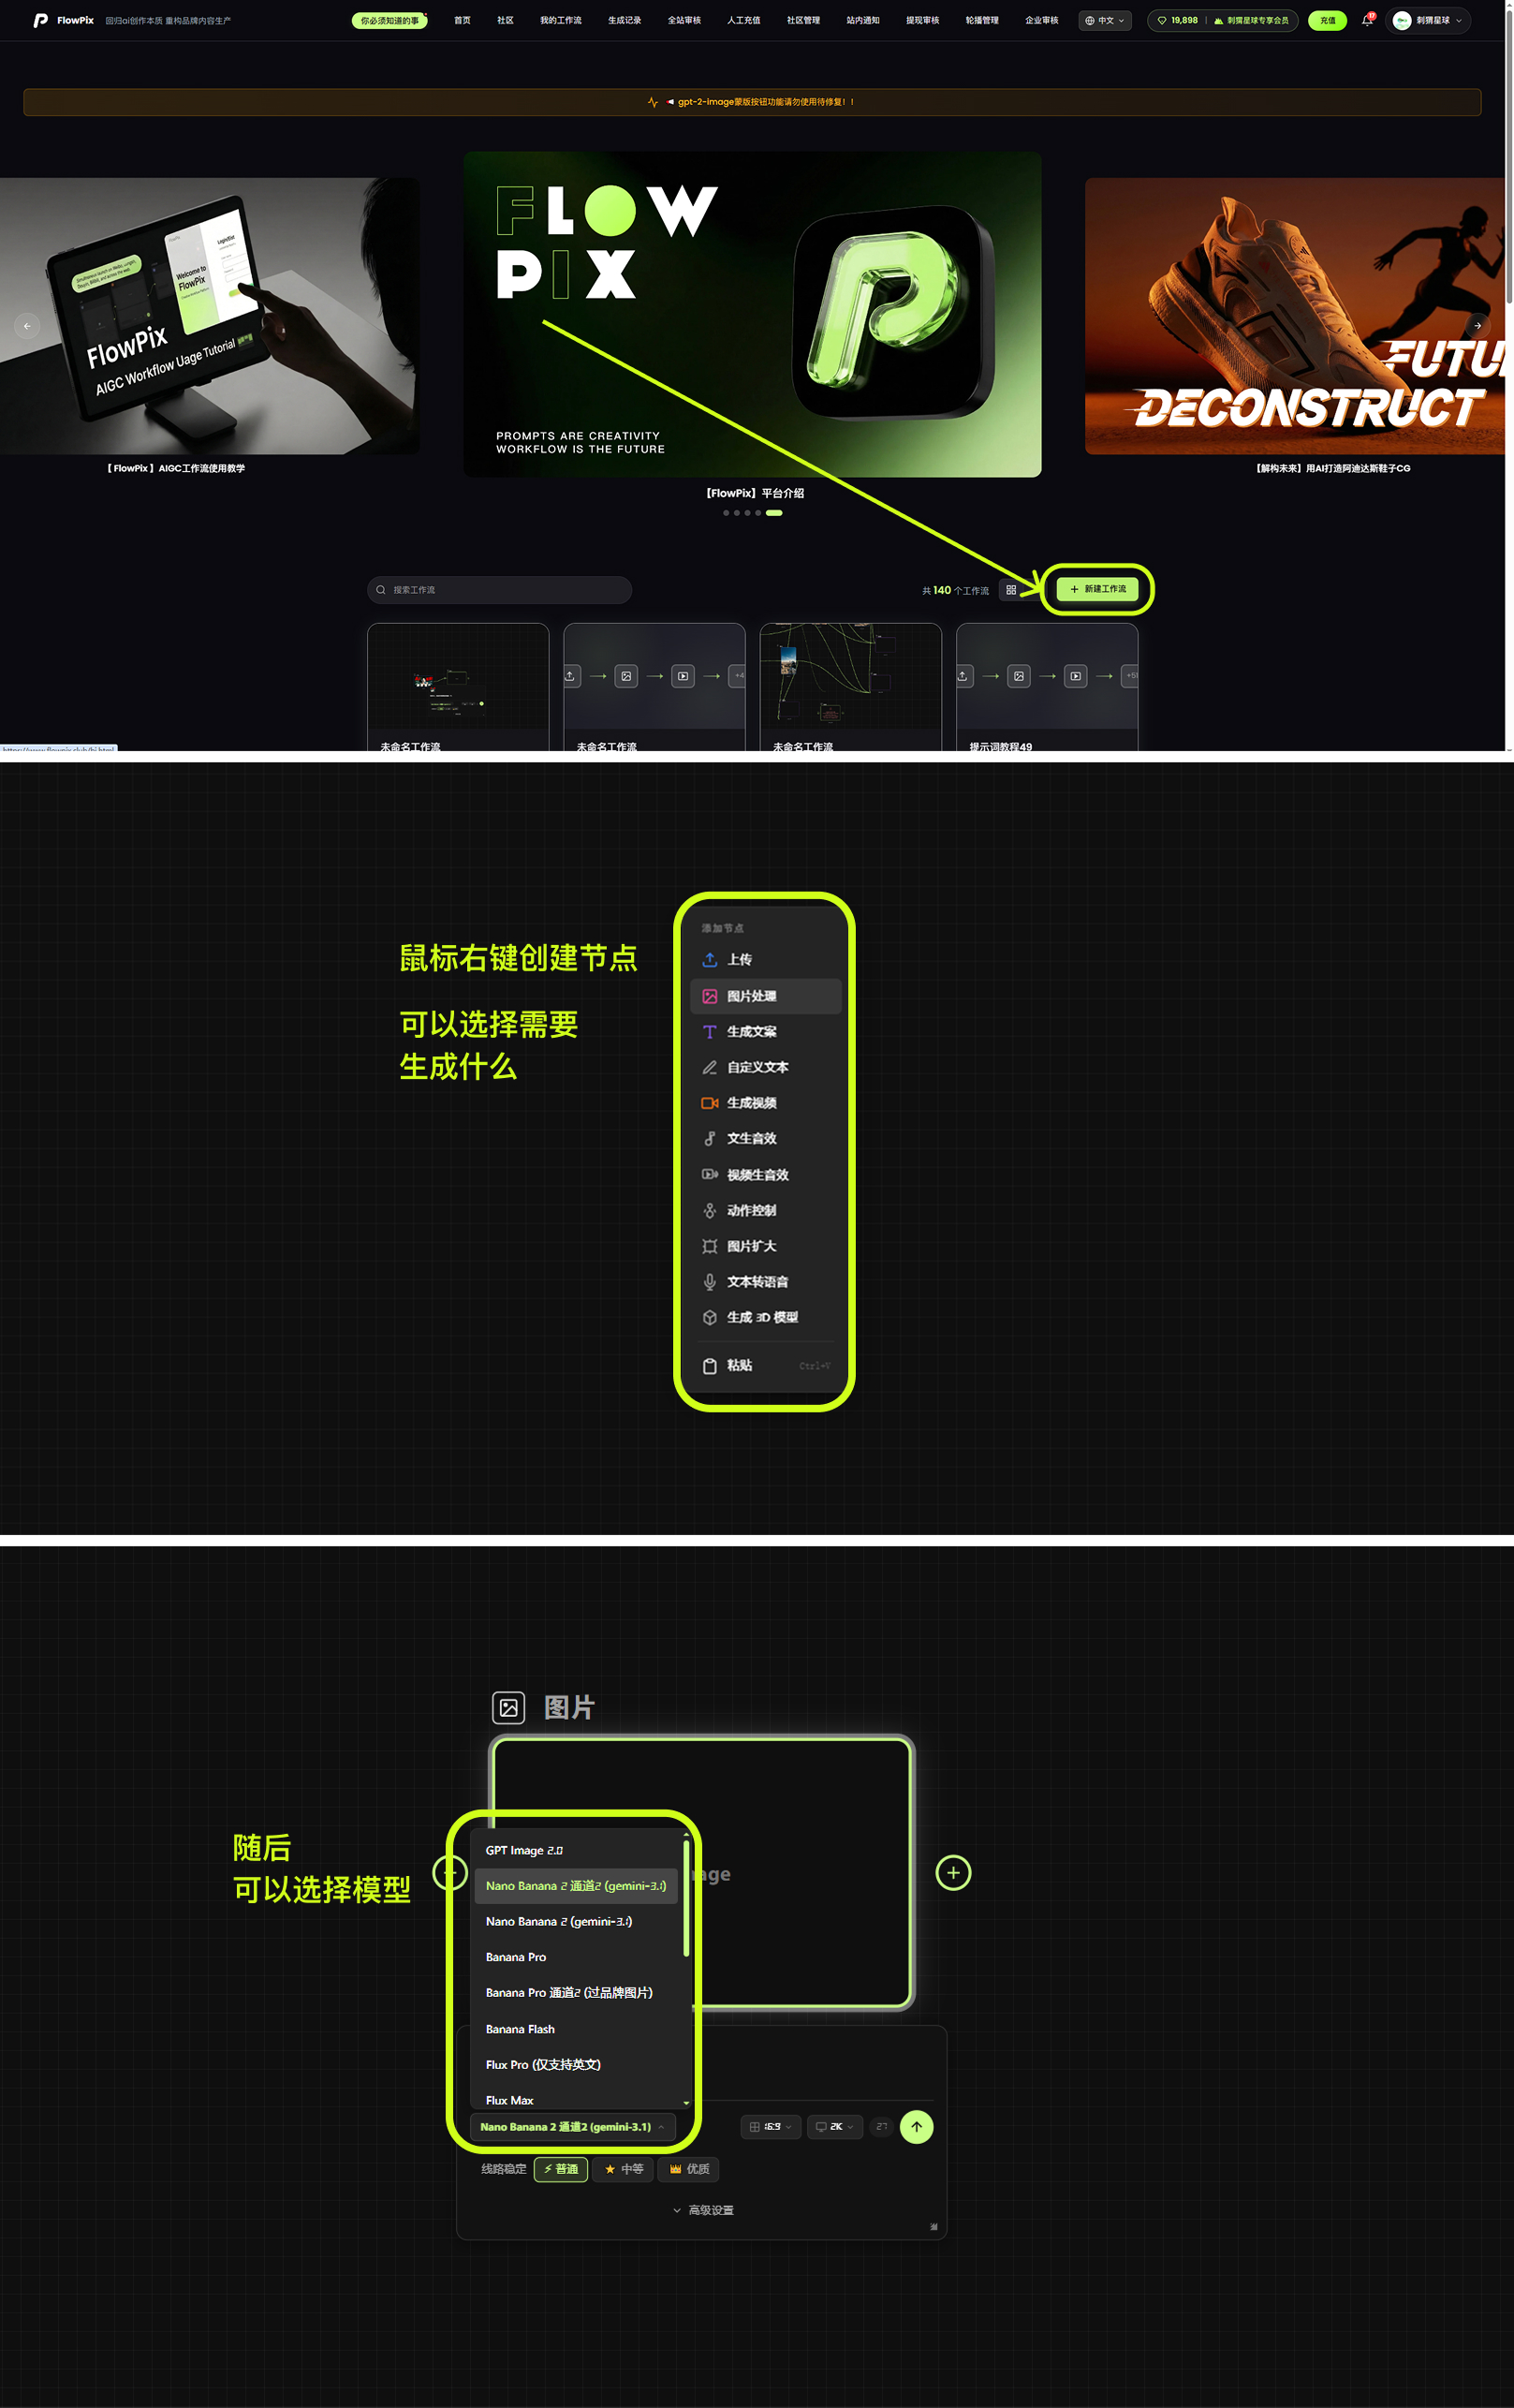
创建步骤
2. Lovart
入口:Lovart 官网。
适合做什么:设计类、品牌设计、Logo、包装、社媒物料、营销活动
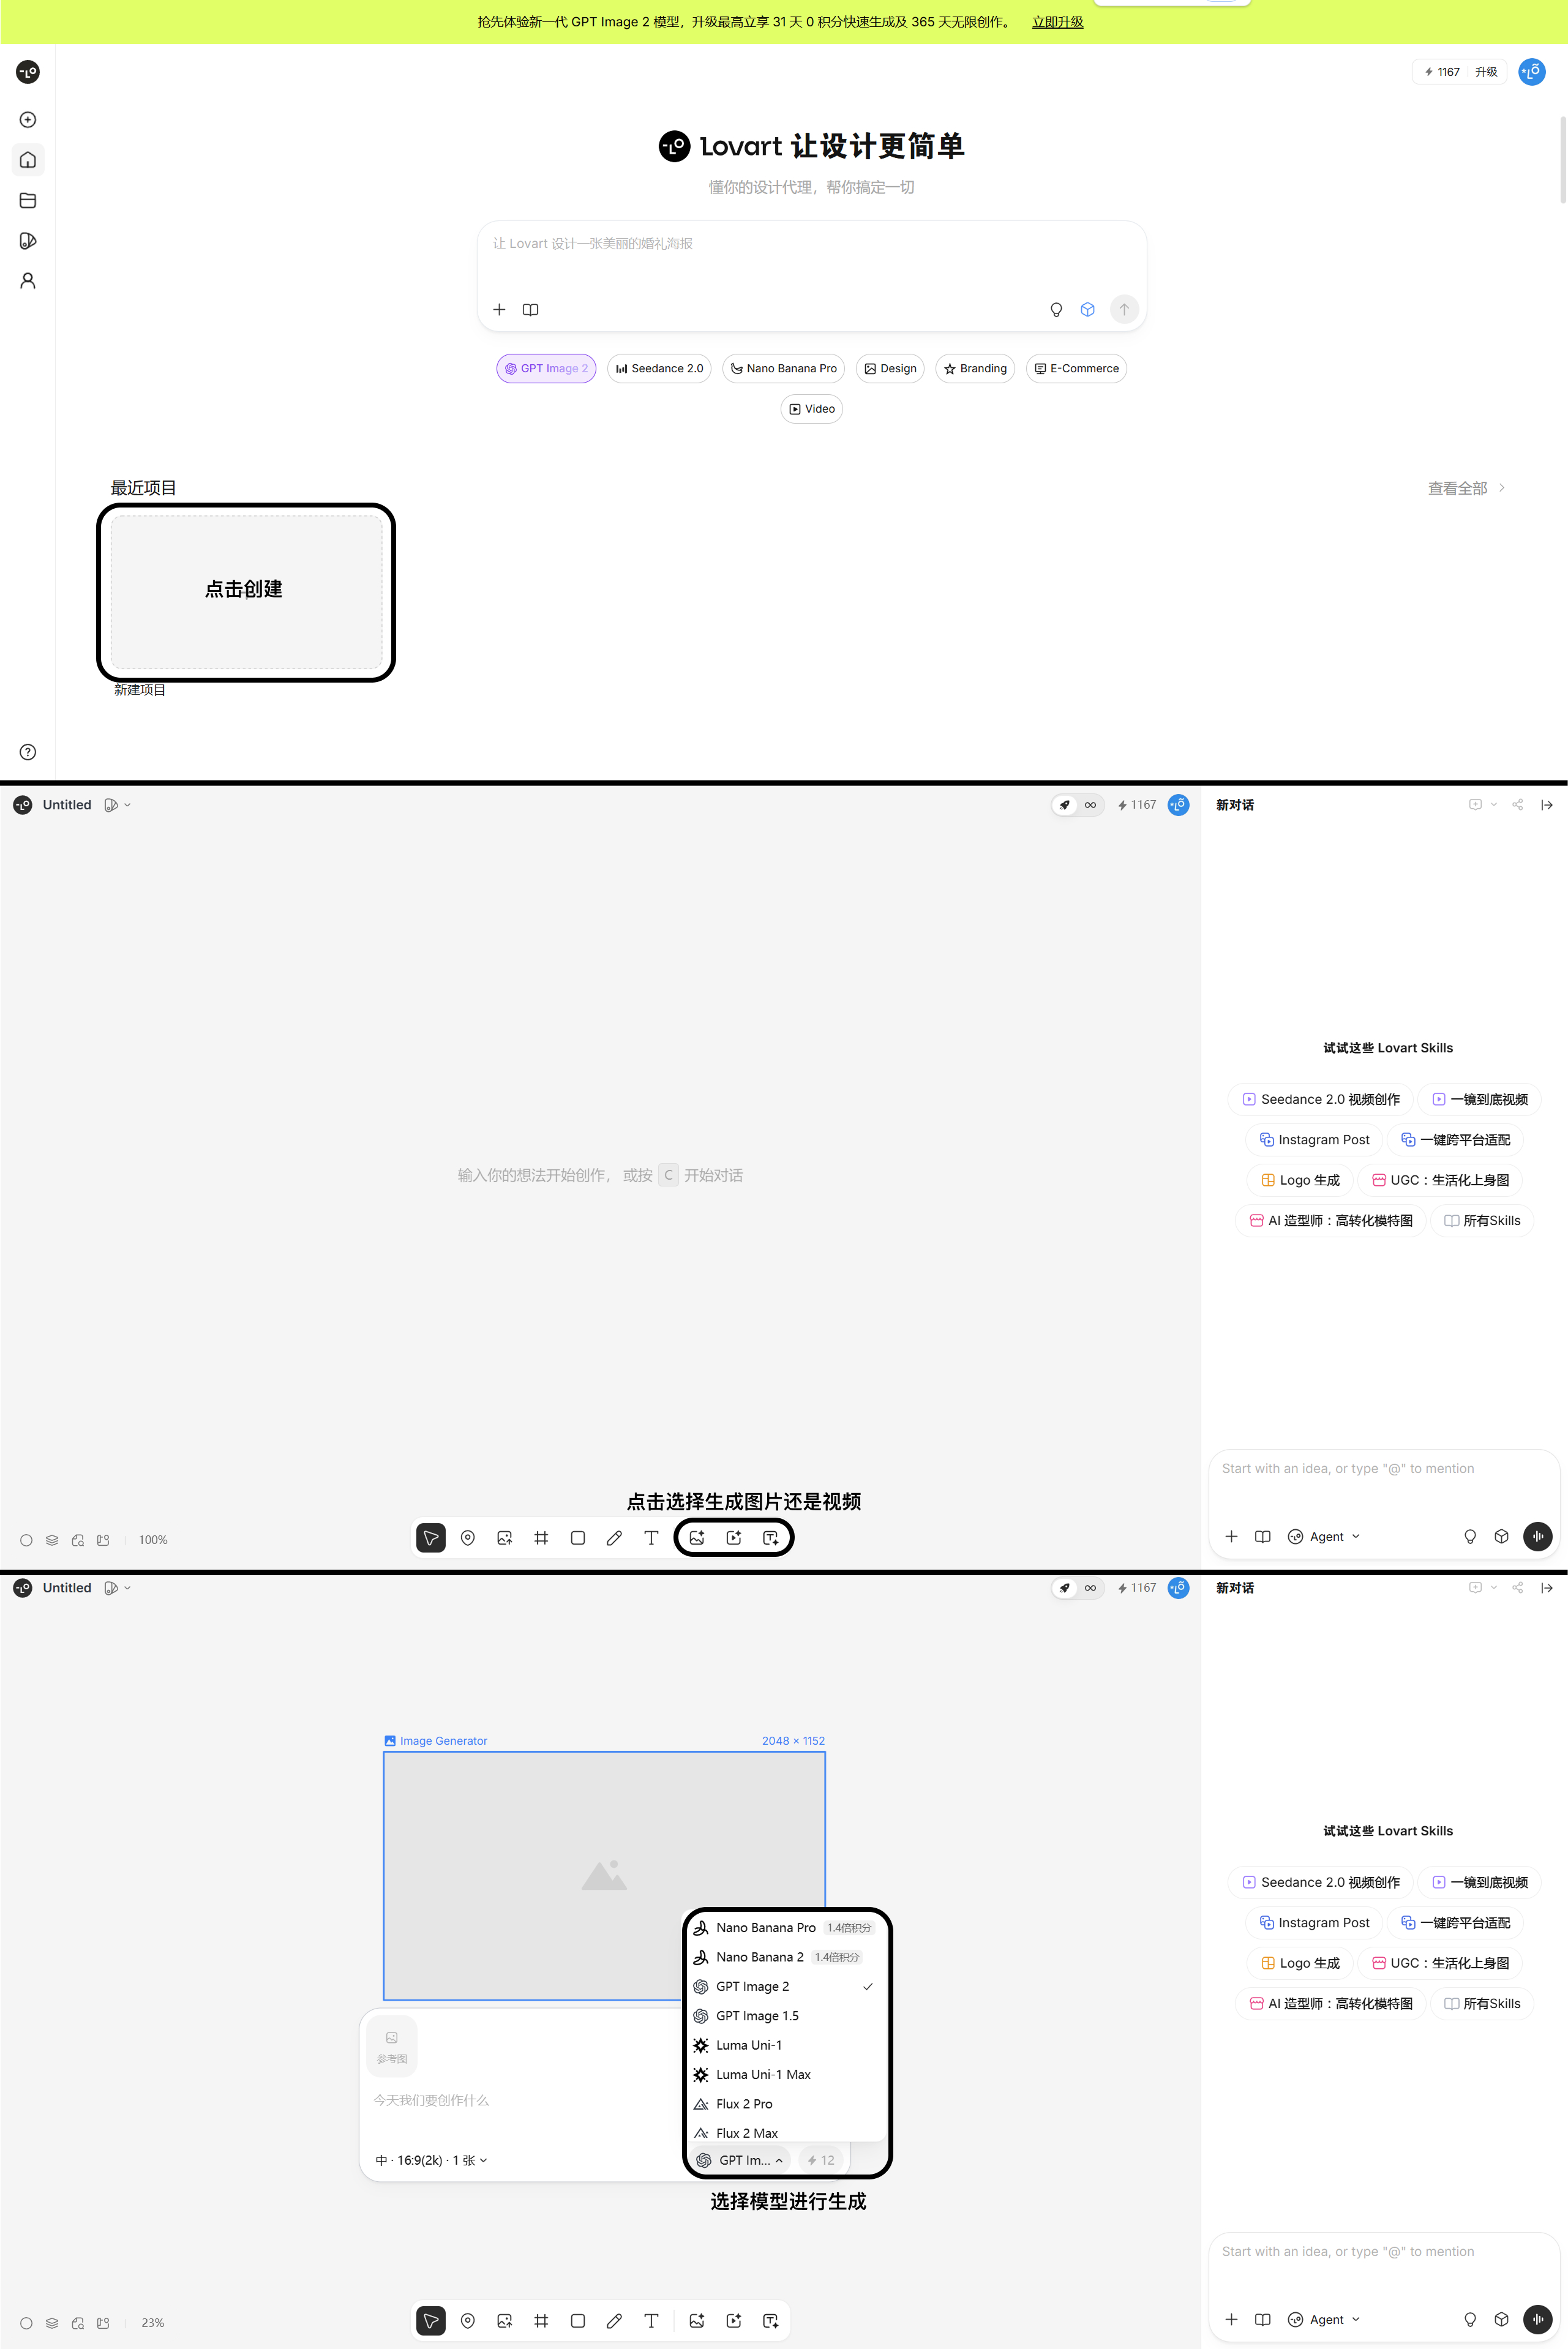
创建节点界面
3. LibTV
入口:LibTV 官网。
适合做什么:视频创作流程、脚本到成片、专业视频协作
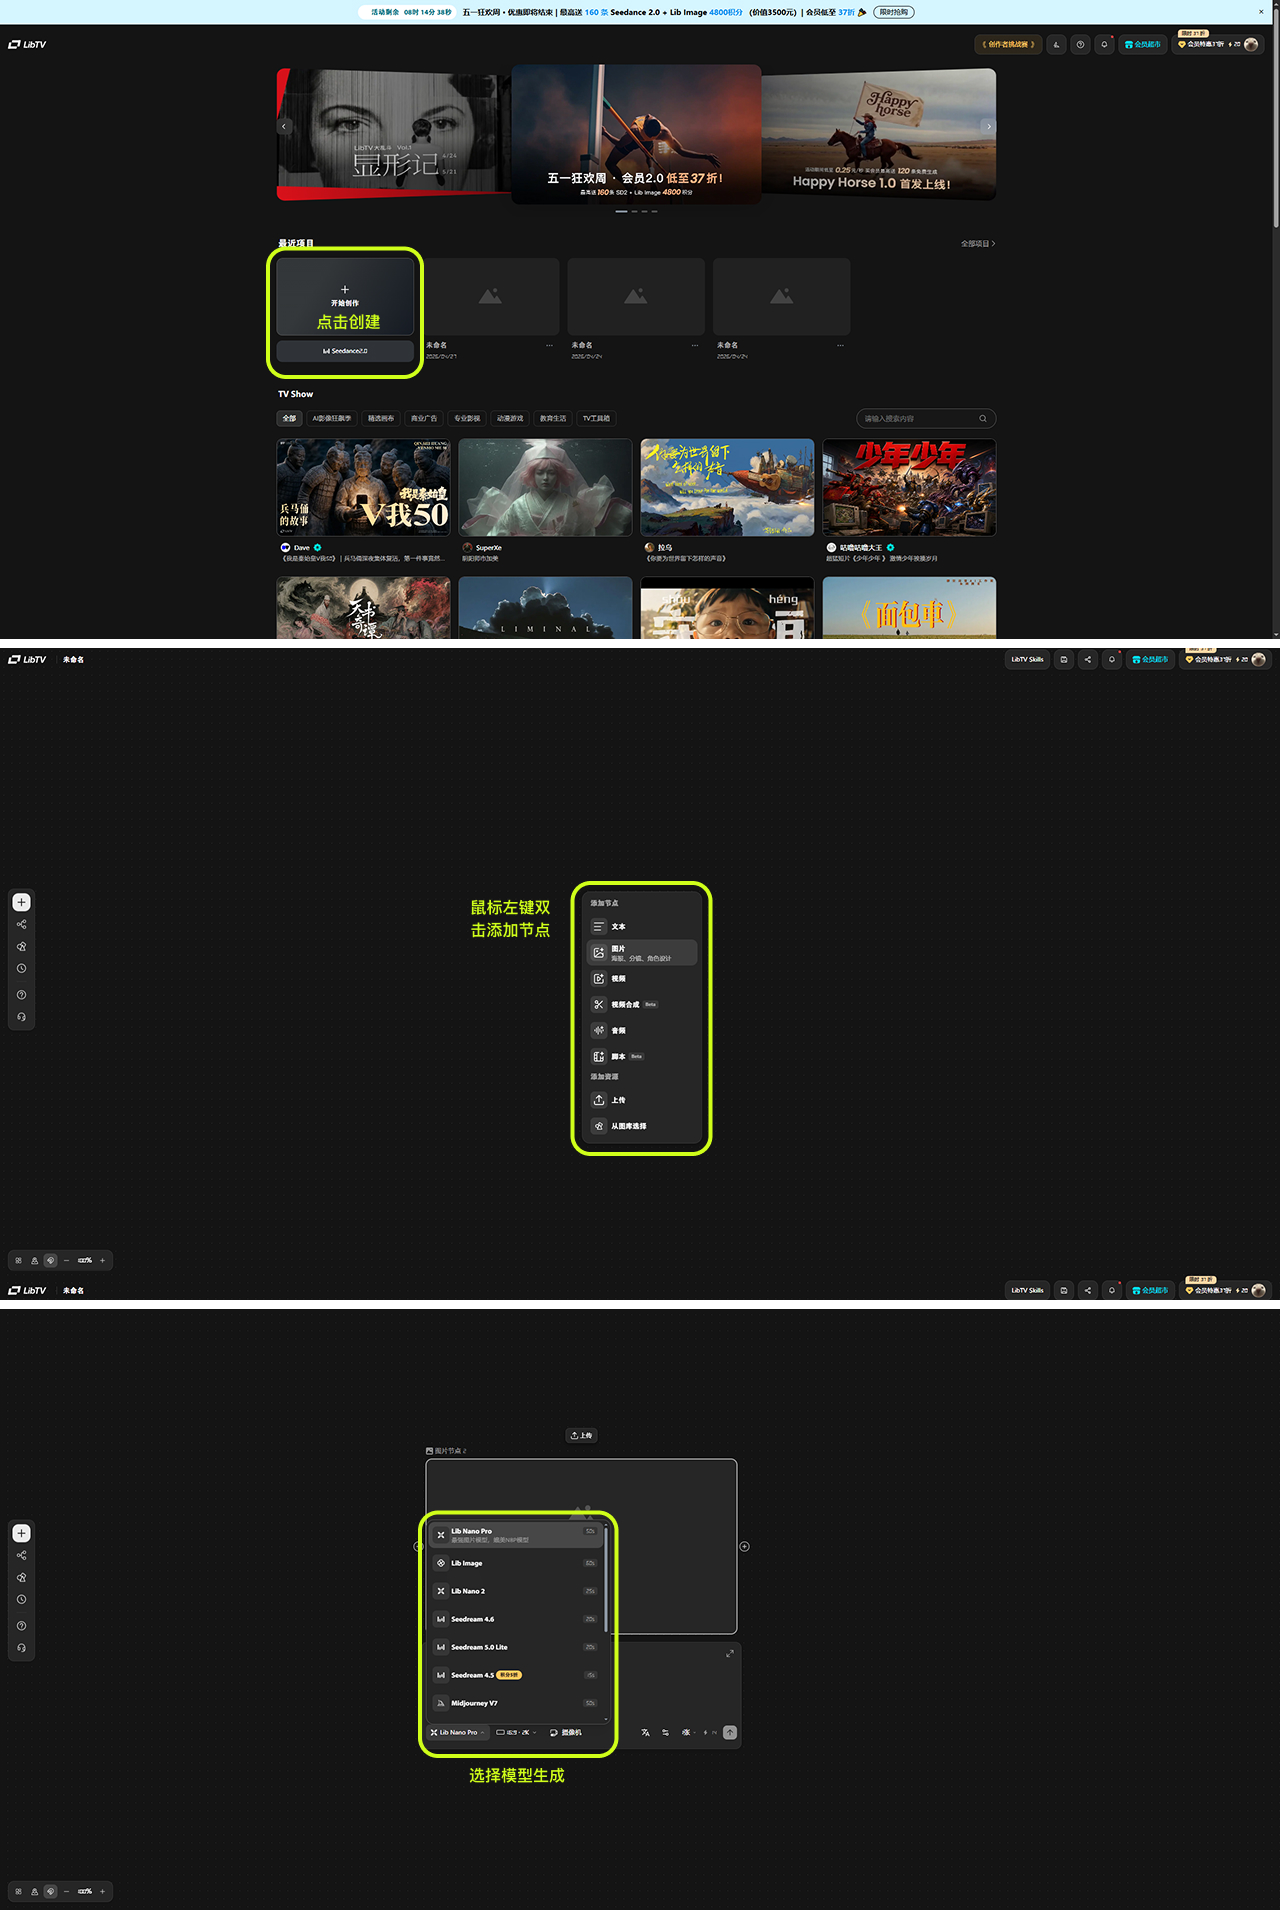
节点创建
4. TapNow(与Libtv类似,都是专注于制作影片)
入口:TapNow 官网 / App。
适合做什么:视觉工作流、短片创作、分镜、品牌视觉
操作步骤与逻辑与Libtv一致
总结
对 AI 小白来说,最重要的不是一口气学会所有工具,而是先建立一个简单认知:
语言大模型负责思考和写作,
图片模型负责视觉设计,
视频模型负责动态表达,
聚合平台可以直接将以上所有平台聚集在一处执行。
入门路线可以很简单:
先用 ChatGPT / Gemini / 豆包写出想法,再用 Nano Banana / GPT Image / 即梦 / Midjourney 生成图片,接着用可灵 / Seedance / Veo 做成短视频。
或者直接用 FlowPix / LibTV / Lovart / TapNow 直接制作完整的作品。
3D 资产执行卡
把这节课压缩成一张可执行卡片:看重点、照步骤、避坑,再复制模板直接开做。
这节课讲的不是单张效果,而是围绕「AI 小白工具入门教程:从聊天、出图到视频创作」把结构、比例和后续可用性一起考虑进去。
按原文节奏走最稳:先吃透「语言大模型:先学会“问问题”和“让 AI 帮你干活”」,再把「图片类工具」定住,接着处理「视频类工具」;最后用「AI 聚合类 / 工作流平台」收口。
- 先把「语言大模型:先学会“问问题”和“让 AI 帮你干活”」里的结构关系定准。
- 这一段重点看能不能继续往建模里走。
- 做完「视频类工具」后,检查比例和材质是否一致。
- 先把「AI 聚合类 / 工作流平台」里的结构关系定准。
- 做完「各家大语言模型各有各的特点与优势,主要的功能差不多(不过国外的模型都明显强于豆包)。」后,检查比例和材质是否一致。
不要只生成一张好看的正面图;要提前考虑三视图、结构一致性、材质分层和后续建模可用性。
检查正侧背是否一致;结构是否可建模;材质是否清楚;比例是否合理;是否能进入下一步建模或动画。
请围绕「AI 小白工具入门教程:从聊天、出图到视频创作」帮我做一个可直接执行的方案。
我的目标是:【填写你的具体目标】
我的素材/产品/角色信息是:【填写已有素材和限制】

请输出:资产结构拆解、正侧背视图提示词、材质说明、可建模注意事项和后续修正清单。要求结构清晰、比例一致。